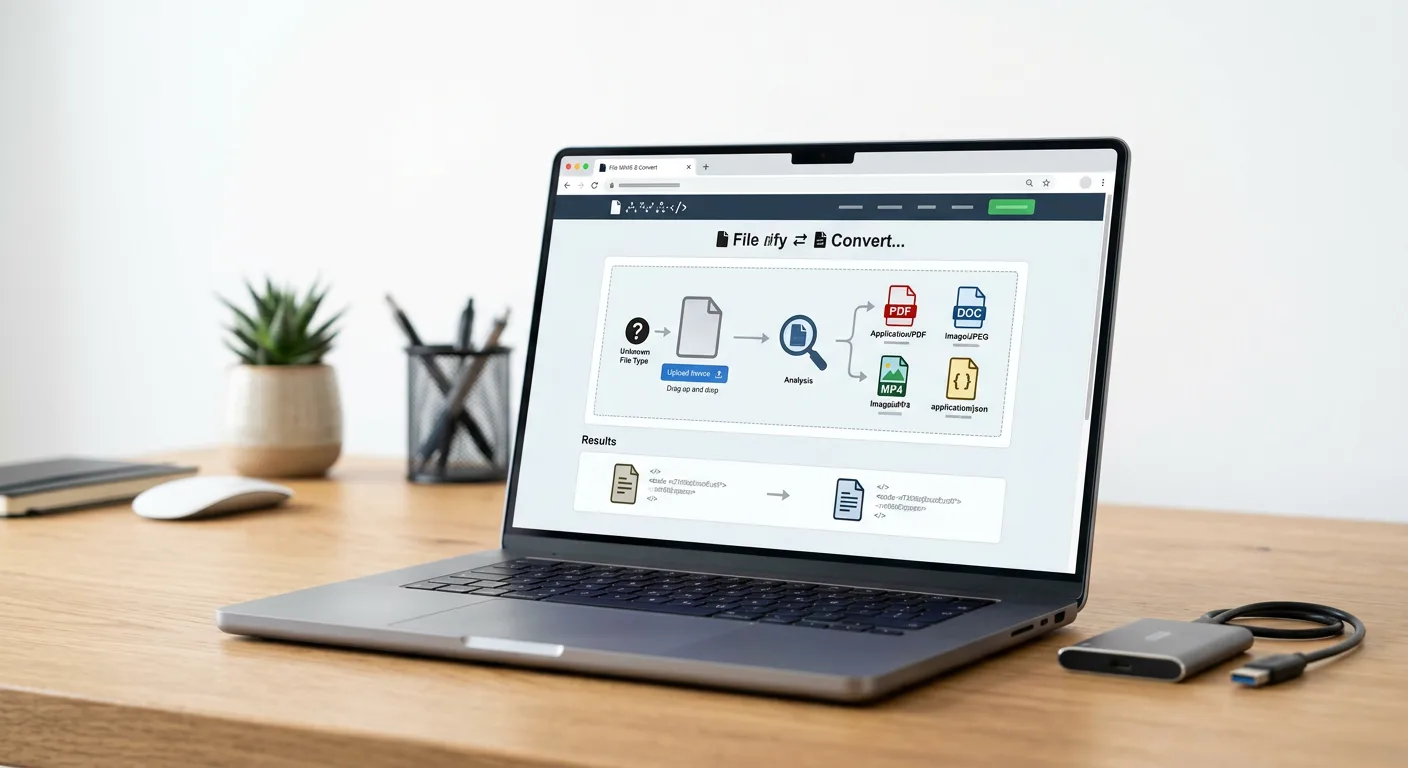
Точное определение типа содержимого файла требуется для безопасной и предсказуемой обработки входящих данных на серверах. Онлайн-инструмент выполняет процедуру Media type detection при загрузке произвольного объекта. Пользователь передает на вход любой файл. В результате анализа генерируется точная строка Content-Type в соответствии с реестром стандартов IANA.
Распознавание формата опирается на прямое чтение бинарной структуры и внутренней сигнатуры. Инструмент полностью игнорирует видимое расширение, так как суффикс имени может быть легко изменен без модификации самого содержимого.
Вебмастера, системные администраторы и разработчики применяют данный метод для строгой валидации. Полученный стандартизированный идентификатор используется при формировании HTTP-заголовков и маршрутизации входящих запросов в API. Это первичная ступень фильтрации. Она предотвращает критические ошибки парсинга и сценарии подмены форматов при загрузке данных пользователями.
Стандарт Multipurpose Internet Mail Extensions: структура и спецификация RFC 6838
Спецификация RFC 6838 регламентирует синтаксис и правила регистрации идентификаторов содержимого, известных как Media types. Стандарт Multipurpose Internet Mail Extensions изначально создавался для почтовых систем, но стал базовым механизмом классификации любых данных в сетевых протоколах, включая HTTP. Централизованным ведением реестра всех допустимых значений занимается IANA. Стандартизация через IANA гарантирует, что каждая генерируемая строка однозначно интерпретируется любым сервером, браузером или шлюзом при маршрутизации трафика.
Идентификатор строится по строгой двухуровневой схеме. Синтаксическая конструкция разделяет принадлежность файла к глобальной категории и его точный внутренний формат. Спецификация выделяет три структурных элемента классификации:
- Основной тип (type): определяет фундаментальную природу и метод базовой обработки содержимого. Значение классифицирует файл как текст, изображение, аудио, видео или бинарный массив произвольного назначения.
- Подтип (subtype): детализирует конкретную спецификацию внутри выбранной категории. Значение указывает на точный кодек, проприетарный формат документа или применяемый алгоритм сжатия.
- Суффикс (Suffix): выступает опциональным компонентом подтипа, который добавляется через знак плюса. Суффикс описывает базовый синтаксис, поверх которого построен формат.
Применение суффиксов позволяет серверным парсерам применять резервные сценарии обработки данных. Если система маршрутизации получает стандартизированный идентификатор application/epub+zip, суффикс информирует обработчик о том, что базовая структура файла является обычным архивом. Это позволяет распаковать содержимое даже в том случае, если точный подтип электронного издания неизвестен принимающей стороне. Аналогичная логика применяется для множества современных форматов, базирующихся на структурах XML или JSON.
В большинстве десктопных операционных систем определение формата традиционно опирается на видимое расширение имени. Данный подход является уязвимым звеном в архитектуре веб-приложений. Расширение представляет собой лишь текстовую часть имени в таблице файловой системы, которая никак не связана с реальными байтами внутри объекта. Любой пользователь может изменить суффикс имени файла, замаскировав исполняемый скрипт под безопасное растровое изображение.
Спецификация RFC 6838 и концепция Media type решают проблему недостоверных метаданных. Классификация привязывается к фактической архитектуре файла. Использование стандартизированных значений IANA вместо проверки расширения обеспечивает предсказуемую логику валидации. Сервер оперирует подтвержденным типом содержимого, игнорируя любые попытки манипуляции с именем загружаемого объекта.
Анализ сигнатуры файла и распознавание форматов на уровне байтов (Byte-level Detection)
Истинная структура цифрового объекта определяется не его именем в файловой системе, а внутренней последовательностью данных. Процесс media type detection строится на чтении бинарного содержимого и поиске уникальных маркеров, заложенных спецификацией конкретного формата. Такой подход гарантирует точную идентификацию типа данных независимо от того, какое расширение было присвоено объекту при сохранении.
Магические числа и бинарные сигнатуры
Большинство стандартизированных форматов содержат в своей структуре фиксированную последовательность байтов, которая выступает в роли внутреннего идентификатора. В инженерной практике эти паттерны принято называть магическими числами (magic numbers). Они представляют собой неизменную константу, которую парсер ожидает встретить в строго определенном месте бинарного потока.
Для технического анализа и машинной обработки сигнатуры традиционно записываются в шестнадцатеричной системе счисления. Полученный hex-код позволяет однозначно описать byte pattern, исключая проблемы кодировок, возникающие при попытке прочитать бинарные данные как обычный текст.
Смещение и позиционирование сигнатуры
Ключевым параметром при чтении магических чисел является смещение (byte offset). Этот показатель определяет точное количество байтов от начала файла, которое необходимо пропустить анализатору для обнаружения сигнатуры. Возможны следующие варианты расположения маркеров:
- Нулевое смещение: сигнатура располагается в самом начале бинарного потока. Это наиболее распространенный стандарт для изображений, документов и современных архивов.
- Фиксированное положительное смещение: маркер находится на определенном расстоянии от начала. Подобная структура характерна для контейнеров, где первые байты отведены под динамические метаданные или резервные заголовки.
- Множественные сигнатуры: формат содержит несколько магических чисел в разных частях структуры, включая завершающие последовательности в конце файла (trailer), подтверждающие целостность объекта.
Примеры шестнадцатеричных сигнатур
Анализ первых байтов позволяет быстро сопоставить прочитанную структуру с известными стандартами. В таблице приведены типичные hex-коды для базовых структур данных с указанием их позиции в файле.
| Формат данных | Hex-код (сигнатура) | Смещение (byte offset) |
|---|---|---|
| 25 50 44 46 2D | 0 | |
| JPEG | FF D8 FF E0 | 0 |
| PNG | 89 50 4E 47 0D 0A 1A 0A | 0 |
| ZIP | 50 4B 03 04 | 0 |
| TAR | 75 73 74 61 72 | 257 |
Алгоритмы эвристического анализа
Распознавание форматов на уровне байтов опирается на методы сопоставления с базой известных шаблонов. Процесс начинается со считывания начального фрагмента данных в память. Затем извлекается byte pattern с учетом заданного смещения и проверяется на совпадение со списком стандартизированных сигнатур. Эта логика полностью аналогична принципам работы классической утилиты file(1) или библиотеки libmagic, которые применяются для глубокого анализа данных в серверных системах.
Если извлеченный hex-код соответствует записи в базе, объекту присваивается точный формат. В ситуациях, когда сигнатура коротка, смещена или повреждена, эвристические методы используют резервные механизмы. К ним относится сканирование общей энтропии данных или поиск специфичных текстовых паттернов внутри структуры, что позволяет с высокой точностью классифицировать объект, не опираясь на внешние атрибуты.
Валидация данных и обнаружение подмены формата (Mismatch Warning)
Поскольку истинный формат объекта устанавливается на основе анализа внутренней структуры байтов, логическим продолжением процесса является сопоставление полученного результата с заявленным расширением. Эта процедура позволяет выявить ситуации, когда имя файла не соответствует его фактическому бинарному содержимому. На практике глубокий анализ структуры выступает надежным механизмом первичной фильтрации входящих данных в системах любого уровня.
При проверке типа файла часто возникает сценарий предупреждения о несоответствии (Mismatch Warning). Такое расхождение указывает либо на случайную ошибку при переименовании документа, либо на намеренную подмену формата. Маскировка потенциально опасных данных под нейтральные типы файлов является стандартизированным вектором обхода базовых систем защиты, которые опираются исключительно на чтение суффикса в имени.
С точки зрения анализа безопасности и оценки уровня риска содержимого, точная идентификация формата служит первым эшелоном проверки. Выявление подмены на этапе чтения бинарной сигнатуры позволяет изолировать подозрительный объект до его передачи на последующие этапы обработки. Использование определения истинного формата в качестве первичного фильтра оптимизирует вычислительные мощности, отсекая аномальные данные до выполнения ресурсоемких криптографических операций проверки целостности, таких как вычисление хеш-суммы SHA-256.
В таблице приведены типичные сценарии валидации, при которых анализ фактического содержимого выявляет подмену и инициирует предупреждение о несоответствии.
| Заявленное расширение | Фактический бинарный формат | Оценка характера несоответствия |
|---|---|---|
| .jpg | application/x-msdownload | Маскировка исполняемого кода под графический файл |
| .txt | text/html | Скрытие активного веб-содержимого внутри плоского текста |
| application/zip | Размещение сжатого архива под видом размеченного документа | |
| .csv | application/vnd.ms-excel | Подмена текстовых табличных данных бинарным форматом |
Категоризация Media Types: от бинарных данных до размеченных документов
После успешного анализа структуры файла результатом идентификации становится строка, указывающая на конкретную категорию содержимого. На фундаментальном уровне все определяемые форматы разделяются на две базовые группы: текстовые и двоичные данные. Понимание разницы между этими архитектурами файлов необходимо для правильной маршрутизации, безопасной обработки и корректного парсинга полученных объектов.
Текстовые форматы содержат последовательности символов, читаемые человеком, и опираются на стандартизированные таблицы кодировок. К этой категории относятся простые текстовые документы, возвращающие значение plain text, табличные наборы данных text/csv, а также язык разметки веб-страниц text/html. Данные в таких файлах хранятся в виде открытого текста, что делает их уязвимыми к внедрению нежелательного кода, но при этом легко анализируемыми.
В противовес им, бинарный файл представляет собой скомпилированную или сжатую последовательность байтов. Для интерпретации двоичных данных требуется специализированное программное обеспечение, способное декодировать специфическую структуру файла. Если бинарная сигнатура файла не совпадает ни с одним из известных форматов, результатом проверки выступает application/octet-stream. Это базовое значение классифицирует файл как неизвестный бинарный формат или произвольный поток байтов, что требует осторожности при его дальнейшей обработке.
Типичные выходные значения и классы форматов
При распознавании форматов возвращаемые идентификаторы группируются по характеру содержащейся информации и предполагаемому способу использования. Ниже представлены основные классы данных и их частые выходные значения:
- Растровые и векторные изображения: Графические данные сжатые с потерями или без. Типичные результаты анализа графики включают image/jpeg, image/png, а также современные форматы веб-изображений, такие как image/webp.
- Аудио- и видео-файлы: Мультимедийные контейнеры, содержащие закодированные потоки данных. Распознаются как audio/mpeg для звуковых дорожек и video/mp4 для видеоконтента.
- Архивы: Сжатые бинарные контейнеры, объединяющие структуру директорий и множество вложенных объектов. Наиболее распространенным результатом анализа архивов является application/zip.
- Структурированные данные и документы: Форматы, предназначенные для машиночитаемого обмена информацией между серверными архитектурами или для точного визуального представления сверстанного текста. Возвращаемые значения включают application/json для сериализованных объектов и application/pdf для размеченных переносимых документов.
Для систематизации получаемых результатов основные категории содержимого и соответствующие им примеры возвращаемых значений представлены в таблице.
| Категория данных | Характеристика содержимого | Частое выходное значение |
|---|---|---|
| Простой и размеченный текст | Читаемые символы и теги гипертекстовой разметки | text/html |
| Графические данные | Растровые массивы пикселей или векторные координаты | image/png |
| Мультимедиа | Синхронизированные аудио и видео потоки | video/mp4 |
| Структурированный обмен | Иерархические сериализованные объекты и массивы данных | application/json |
| Сжатые контейнеры | Архивированные наборы файлов с таблицами смещений | application/zip |
| Неизвестные двоичные данные | Нераспознанный поток байтов без явной структуры | application/octet-stream |
Значение точного Content-Type для HTTP-заголовков и веб-архитектуры
Полученное в результате анализа значение стандарта IANA находит непосредственное практическое применение при конфигурации веб-серверов и проектировании архитектуры обмена данными. Основным механизмом передачи информации о формате полезной нагрузки выступает HTTP-заголовок Content-Type. Указание точного значения в этом заголовке гарантирует, что клиентское приложение или принимающий сервер корректно инициализируют нужный парсер для обработки входящего потока байтов.
При разработке RESTful API строгая типизация контента критична для маршрутизации запросов. Сетевая инфраструктура опирается на Content-Type для определения логики десериализации данных перед передачей их контроллерам приложения. Например, при передаче бинарных файлов через веб-формы применяется спецификатор multipart/form-data, который указывает парсеру на наличие разделителей между различными блоками полезной нагрузки. Предварительное знание фактического формата загружаемого объекта позволяет серверу не только безопасно сохранить данные, но и правильно сформировать ответные заголовки при последующей отдаче этого контента конечным пользователям.
Отсутствие или некорректное указание заголовка приводит к активации механизма MIME-sniffing на стороне браузера. Если сервер возвращает дефолтное или ошибочное значение для размеченного документа, клиентское приложение попытается эвристически угадать реальный формат на основе анализа начальных байтов ответа. Подобное поведение создает архитектурную уязвимость: если злоумышленник загрузит исполняемый скрипт под видом графического объекта, браузер может проигнорировать безопасный контекст картинки и выполнить код.
Для предотвращения проблем с маршрутизацией и уязвимостей применяются следующие архитектурные практики на основе точного определения типа содержимого:
- Настройка отдачи статических ресурсов через конфигурационные файлы веб-серверов для принудительного связывания конкретных директорий с правильными заголовками ответа.
- Блокировка эвристического анализа в браузерах путем совместной передачи точного заголовка Content-Type и директивы X-Content-Type-Options со значением nosniff.
- Организация строгой валидации полезной нагрузки на шлюзах API, где запросы с несоответствующим или подозрительным типом данных отклоняются до попадания во внутреннюю сеть.
- Управление правилами кэширования на уровне CDN, где время жизни объекта и алгоритмы сжатия зависят от заявленной медиа-категории файла.
Точное сопоставление физической структуры файла с сетевыми заголовками исключает расхождения между тем, что отправляет сервер, и тем, что ожидает получить клиент. Это делает процесс взаимодействия систем предсказуемым и защищенным от атак, связанных со смешением протоколов и форматов.
Порядок работы с онлайн-инструментом определения MIME-типа
Процесс распознавания формата начинается с подачи целевого файла на вход инструмента. В качестве исходных данных принимается произвольный файл независимо от его текущего расширения или первоначального названия, присвоенного операционной системой.
Анализ структуры файла выполняется исключительно за счет локальной обработки данных. Применение парадигмы client-side обработки означает, что чтение бинарной сигнатуры происходит непосредственно в оперативной памяти клиентского устройства средствами браузера. Содержимое исходного файла не передается на сторонние серверы по сети, что исключает риски перехвата или утечки информации при проверке конфиденциальных корпоративных документов, закрытых архивов или персональных данных.
Результатом выполнения аналитической операции является вывод нормализованной строки стандарта IANA, отражающей фактический тип содержимого. Инструмент предоставляет точное значение, состоящее из базовой медиа-категории и конкретного подтипа, которое интерпретируется как истинный формат загруженных данных.
| Выходное значение | Интерпретация результата | Сценарий применения |
|---|---|---|
| image/webp | Современный формат растровой графики | Оптимизация доставки изображений на веб-сайтах |
| application/json | Структурированные текстовые данные | Обмен полезной нагрузкой в REST API |
| application/octet-stream | Неизвестный бинарный формат | Принудительное скачивание файла клиентом |
Полученное после локальной проверки значение применяется для настройки сетевой инфраструктуры и разработки механизмов безопасной маршрутизации данных. Выявленная строка выступает эталонным идентификатором при написании конфигураций и логики проверки на сервере.
- Настройка HTTP-заголовков: точная строка используется для конфигурации директив веб-серверов при отдаче статического контента. Привязка выявленного значения к заголовку Content-Type гарантирует, что клиентские приложения корректно интерпретируют и безопасно обработают запрашиваемый ресурс.
- Разработка правил валидации: полученный идентификатор применяется на стороне сервера для создания строгих белых списков допустимых форматов. Backend-система использует эталонные значения для сравнения с тем типом данных, который пытается передать клиент при загрузке полезной нагрузки, отбрасывая запросы с подмененным содержимым до этапа сохранения на диск.
Интеграция полученных точных значений в архитектуру приложения позволяет устранить уязвимости, связанные с доверием к пользовательскому вводу, и стандартизировать обработку входящих и исходящих потоков данных.