Преобразование PDF в текстовый файл - это технический процесс извлечения машиночитаемых символов из документа с жестко заданной визуальной структурой. Инструмент выполняет парсинг исходных данных. Он изолирует текстовый слой и переносит его содержимое в плоский линейный формат. На выходе пользователь получает сырой текст, полностью очищенный от графических объектов, векторных контуров и сложной разметки.
Сгенерированный файл TXT отдается с типом MIME text/plain. Это базовый формат, который физически не поддерживает сохранение размеров шрифтов, цветов или выравнивания колонок. Для корректной обработки текстового массива применяется кодировка UTF-8. Использование данного стандарта исключает появление битых кодировок при работе с многоязычными документами и специальными символами.
Исходный визуальный макет отбрасывается.
Блоки текста, которые в PDF позиционируются по абсолютным координатам на странице, выстраиваются в единый непрерывный поток. Инструмент сохраняет только базовую логику разделения абзацев и разрывов строк. Отсутствие скрытых артефактов форматирования позволяет сразу применять полученные данные для загрузки в базы данных, машинного анализа или обработки консольными утилитами.
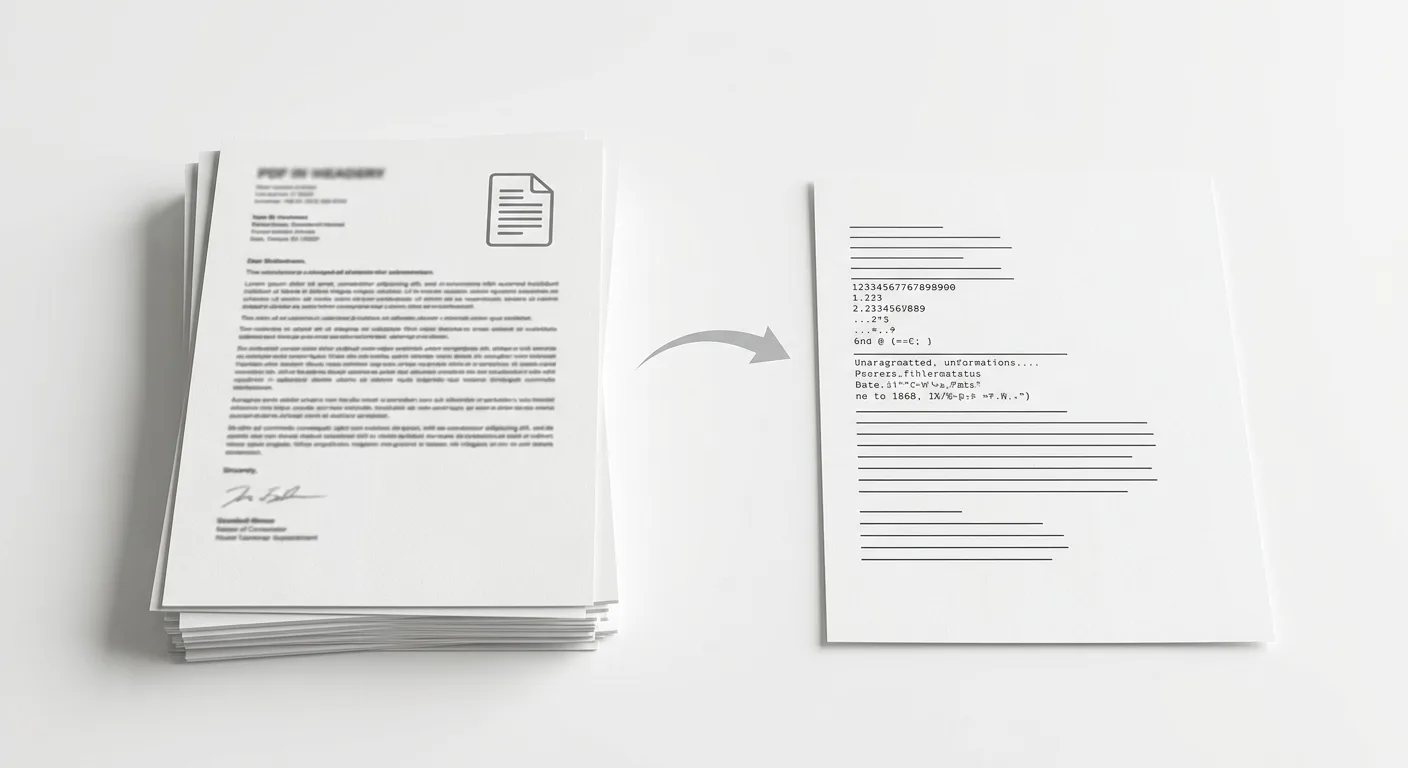
Принцип извлечения текста из структуры PDF-документа
Архитектура исходного и конечного файлов имеет принципиальные различия. Формат PDF представляет собой визуально-ориентированный макет, созданный для точного отображения документа на любых устройствах. Внутри такой структуры текст не хранится как единый связанный абзац. Каждый символ или группа символов является отдельным объектом, который позиционируется на виртуальном холсте по строгим координатам осей X и Y. Plain Text имеет принципиально иную природу - это линейная структура, где данные следуют строго последовательно, формируя одномерный поток без координат и привязок к физической странице.
Понимание процесса парсинга требует разделения документа на визуальную и структурную составляющие.
| Характеристика | Структура PDF | Структура Plain Text |
|---|---|---|
| Принцип организации макета | Визуально-ориентированный холст | Линейная текстовая последовательность |
| Позиционирование контента | Абсолютные координаты на плоскости | Естественный порядок следования символов |
| Внутреннее содержимое | Текстовый слой, векторные кривые, растр, метаданные | Исключительно машиночитаемые символы |
Преобразование основывается на работе алгоритма парсинга, который анализирует внутреннее дерево объектов исходного файла. Парсер не делает снимок экрана и не анализирует пиксели, он читает внутренние инструкции документа. Процесс направлен исключительно на локализацию тех массивов, которые содержат текстовые операторы.
Алгоритм извлечения текста включает следующие этапы и правила фильтрации объектов:
- Чтение команд текстового слоя и извлечение закодированных последовательностей из структуры файла.
- Идентификация символов посредством сопоставления внутренних словарей шрифтов PDF с таблицами символов для корректного перевода кодов в читаемый текст.
- Полное игнорирование графических элементов, включая любые встроенные растровые изображения, диаграммы, фоновые заливки и векторные линии.
- Исключение всех служебных и бинарных данных, таких как метаданные документа, цифровые подписи, закладки и интерактивные слои.
В результате парсинга система изолирует только те байты, которые могут быть однозначно интерпретированы как текст. Операция чтения отбрасывает весь машинный код, описывающий графику или компоновку исходного макета. На следующий этап обработки передаются только идентифицированные символы, что позволяет сформировать чистый массив данных, лишенный любых нетекстовых примесей.
Спецификация формата TXT и поддерживаемые кодировки
Сформированный массив идентифицированных символов записывается в выходной файл, который строго соответствует спецификации MIME-типа text/plain. Данный формат представляет собой линейную последовательность данных, состоящую исключительно из читаемых знаков и базовых управляющих кодов. Отсутствие скрытой стилистической разметки, XML-тегов или проприетарных структурных метаданных делает конечный файл универсальным и полностью независимым от программной среды.
Спецификация генерируемого документа опирается на следующие технические параметры:
| Параметр файла | Техническое значение | Назначение в структуре данных |
|---|---|---|
| MIME-тип | text/plain | Обозначение неформатированного текстового потока |
| Стандарт символов | Unicode | Универсальная таблица идентификации знаков |
| Кодировка | UTF-8 | Стандарт преобразования символов в байтовые последовательности |
Для обеспечения точной интерпретации текстовых массивов на любых устройствах применяется стандарт UTF-8. Эта кодировка позволяет без потерь сохранять сложное многоязычное содержимое. Использование UTF-8 гарантирует корректное отображение кириллицы, латиницы, азиатских иероглифов, а также специфических типографских знаков. Единая стандартизация кодирования исключает появление нечитаемых символов или конфликтов регистров при чтении файла.
В процессе записи линейного текстового потока спецификация text/plain требует точного сохранения системных невидимых символов, которые отвечают за разделение слов и строк. Обычные и неразрывные пробелы из исходного кода транслируются в стандартные пробельные символы. Особое внимание уделяется обработке разрывов строк, так как архитектура различных операционных систем требует применения специфических управляющих кодов для корректного переноса текста на новую строку.
Логика обработки маркеров конца строки опирается на следующие стандарты системных символов:
- Двойная последовательность CR+LF применяется в качестве стандарта для сред Windows, обеспечивая возврат каретки и перевод строки.
- Одиночный маркер LF используется для обозначения конца строки в Unix-системах, что обеспечивает нативную совместимость с macOS и дистрибутивами Linux.
Точная трансляция системных пробелов и правильная расстановка маркеров конца строки сохраняют структурную целостность потока. В результате формируется стандартизированный файл, содержащий только валидные байты кодировки UTF-8, готовый к аппаратному чтению или передаче в другие системы без риска искажения символов.
Обработка визуального макета и трансформация структуры
Формат PDF использует абсолютную систему координат, жестко фиксируя позицию каждого символа, слова или графического элемента на странице с помощью значений осей X и Y. В отличие от него, формат TXT представляет собой одномерный линейный поток данных. Процесс преобразования требует перевода пространственного расположения разрозненных текстовых блоков в последовательную цепочку символов. Элементы, позиционированные на исходной странице визуально, выстраиваются в единый текст на основе логического порядка чтения, который определяет направление выгрузки данных сверху вниз и слева направо.
Переход от визуально-ориентированного макета к простому тексту означает полную очистку данных от стилистической разметки. Поскольку спецификация text/plain не поддерживает передачу параметров дизайна, в процессе трансформации происходит неизбежная потеря сложного визуального форматирования. В целевой файл не переносятся следующие атрибуты исходного документа:
- Размеры, гарнитуры и начертания шрифтов полностью игнорируются, в поток записываются только сами текстовые значения.
- Цветовое оформление текста, выделения маркером и цвет фона удаляются.
- Интерактивные элементы, гиперссылки, сноски и скрытые слои очищаются, оставляя только видимый текстовый слой.
Сложные пространственные структуры документа требуют применения строгой логики линеаризации для сохранения смысловой целостности. Если макет содержит многоколоночную верстку, текстовые блоки обрабатываются последовательно: содержимое первой колонки полностью переносится в текстовый поток до перехода к чтению второй. Табличные матрицы преобразуются в текст с разделителями. В этом случае визуальная сетка разрушается, а значения ячеек одной строки выстраиваются в непрерывную последовательность, отделяясь друг от друга пробелами или символами табуляции.
Особое внимание при трансформации макета уделяется правилам сохранения абзацев и логике обработки разрывов строк. В исходном файле визуальный перенос строки часто достигается за счет изменения Y-координаты следующего слова, а не наличием системного символа переноса. При формировании линейного потока анализируются расстояния между строками и текстовыми блоками. Если расстояние между строками соответствует стандартному интервалу текущего блока, разрывы строк игнорируются, а текст объединяется пробелами в непрерывное предложение. Если система координат показывает увеличенный интервал или отступ, свидетельствующий о начале нового абзаца, в текстовый файл внедряются соответствующие маркеры конца строки, что позволяет сохранить логическое структурное разделение на абзацы.
Различия обработки машиночитаемых файлов и сканированных страниц
Технический процесс извлечения данных напрямую зависит от внутренней архитектуры исходного документа. Входные файлы строго разделяются на две категории: машиночитаемые документы с внедренным текстовым слоем и растровые массивы, представляющие собой отсканированные изображения. Цифровые PDF содержат готовые текстовые векторы и таблицы кодировок, что позволяет считывать информацию путем прямого парсинга структурных элементов. Растровые PDF лишены текстового слоя - страница сохранена как единая непрерывная сетка пикселей.
Архитектурные и процессуальные отличия двух типов документов определяют логику работы с ними:
| Характеристика | Машиночитаемый PDF | Растровый PDF |
|---|---|---|
| Внутренняя структура | Векторные элементы, шрифты, метаданные | Матрица пикселей, графическое изображение |
| Представление текста | Символы с заданными координатами | Светлые и темные участки изображения |
| Механизм извлечения | Прямое чтение текстового слоя | Оптическое распознавание символов |
При работе с отсканированными страницами прямой парсинг не дает результатов, так как файл содержит только значения цвета для каждого пикселя, а не буквенные символы. Для преобразования графической сетки скана в линейный текстовый поток применяется технология OCR. Данный механизм необходим для перевода визуальных образов в цифровой текст, пригодный для записи в целевой формат TXT.
Базовый принцип работы OCR строится на математическом анализе пиксельных матриц. Алгоритм сканирует изображение, выявляя контрастные паттерны - области темных пикселей на светлом фоне. Найденные контуры сегментируются и сопоставляются с заложенными в систему геометрическими моделями символов и словарями. После идентификации графического паттерна алгоритм присваивает ему соответствующий код из стандартизированной таблицы символов. Таким образом нечитаемое графическое пятно трансформируется в конкретную букву или цифру.
Точность извлечения текста из растровых источников критически зависит от качества исходного изображения. Наличие оптических шумов, искажения перспективы, низкое разрешение сканирования или артефакты алгоритмов сжатия усложняют идентификацию контуров. В условиях недостаточной контрастности механизм оптического распознавания испытывает сложности с разделением слипшихся символов или интерпретацией визуально схожих знаков. Для корректного формирования итогового текстового файла требуется технически пригодный исходник, позволяющий алгоритмам однозначно идентифицировать графические формы.
Практические сценарии использования Plain Text
Полученный в результате преобразования формат TXT отличается полным отсутствием скрытой разметки и визуального форматирования. Эта структурная простота делает его универсальным носителем для задач, где требуется чистый поток данных без посторонних графических или стилевых элементов. Линейная организация содержимого позволяет применять извлеченный текст в различных технических и пользовательских сценариях.
Основные направления применения очищенного текстового массива:
- Очистка исходного текста для безопасной вставки в CMS. При прямом копировании контента из сложных документов вместе со словами часто переносятся невидимые артефакты форматирования, нестандартные пробелы или обрывки исходного кода. Промежуточный файл TXT отсекает все скрытые стили, теги и позиционные данные, исключая риск нарушения верстки целевой веб-страницы.
- Подготовка сырых текстовых датасетов для машинного обучения. Алгоритмам обработки естественного языка требуются массивы данных без визуального шума. Текстовые потоки легко токенизируются и загружаются в тренировочные пайплайны без необходимости применять сложные парсеры для обхода визуальных макетов.
- Автоматизированная обработка данных в скриптах. Техническая документация или логи, переведенные в текстовый вид, легко поддаются обработке с помощью регулярных выражений и утилит командной строки. Из линейного массива удобно программно извлекать конкретные конфигурации, системные значения или фрагменты кода.
- Чтение в базовых системных редакторах. Для открытия и просмотра сформированного файла не требуются специализированные просмотрщики. Данные мгновенно открываются в штатных программах вроде Notepad или TextEdit, независимо от используемой операционной системы и вычислительной мощности устройства.
- Взаимодействие с программами чтения с экрана. Чистый текстовый поток обеспечивает максимальную совместимость с ассистивными технологиями. Screen readers последовательно синтезируют речь из линейного текста, не прерываясь на нераспознанные графические элементы или сложную структуру колонок.
Протоколы безопасности при браузерной конвертации файлов
При передаче документов между локальным вычислительным устройством и сервером применяется защищенный протокол HTTPS. Весь сетевой трафик проходит через криптографическое шифрование транспортного уровня. Это исключает перехват данных на этапах передачи исходного файла и скачивания готового результата. Содержимое исходного документа и результирующего текстового потока защищено от несанкционированного доступа со стороны интернет-провайдеров или транзитных сетевых узлов.
На этапе серверной обработки реализуется принцип строгой изоляции данных. Для каждой операции конвертации выделяется независимый процесс. Извлечение текстового содержимого выполняется локально в пределах изолированной области оперативной памяти, без передачи фрагментов документа сторонним сервисам. Программная архитектура гарантирует, что данные разных сессий не пересекаются, а само текстовое содержимое недоступно извне в момент работы алгоритмов.
Жизненный цикл обрабатываемых файлов строго ограничен временем выполнения операции и передачи результата. Защита конфиденциальной информации обеспечивается алгоритмом автоматического удаления, который работает по следующему сценарию:
- Исходный документ PDF стирается из временного пространства немедленно после успешного чтения структуры и извлечения текстовых блоков.
- Сгенерированный файл TXT хранится в оперативной памяти исключительно на время, необходимое для обеспечения корректного скачивания через браузер.
- Все выделенные сегменты памяти принудительно обнуляются после завершения сессии передачи данных или при срабатывании стандартного системного тайм-аута.
- Скрытые кэш-файлы, фрагменты извлеченного текста и метаданные не логируются и не сохраняются на физических носителях сервера.