Исключение столбцов из таблицы представляет собой целенаправленное изменение структуры данных. Инструмент удаляет выбранные вертикальные диапазоны. На вход подается исходный табличный массив. Система исключает указанные блоки и автоматически перестраивает сетку. Результатом становится очищенный набор информации, пригодный для импорта или анализа.
Главная задача инструмента заключается в подготовке массивов информации. Удаление нерелевантных вертикальных диапазонов снижает физический объем документа.
Информационные базы и учетные системы часто экспортируют избыточные метрики. Хранить их в рабочих файлах непрактично. Очистка массива за счет отсечения лишних столбцов убирает технический мусор. При выполнении этой операции горизонтальные связи между ячейками в строках остаются неизменными.
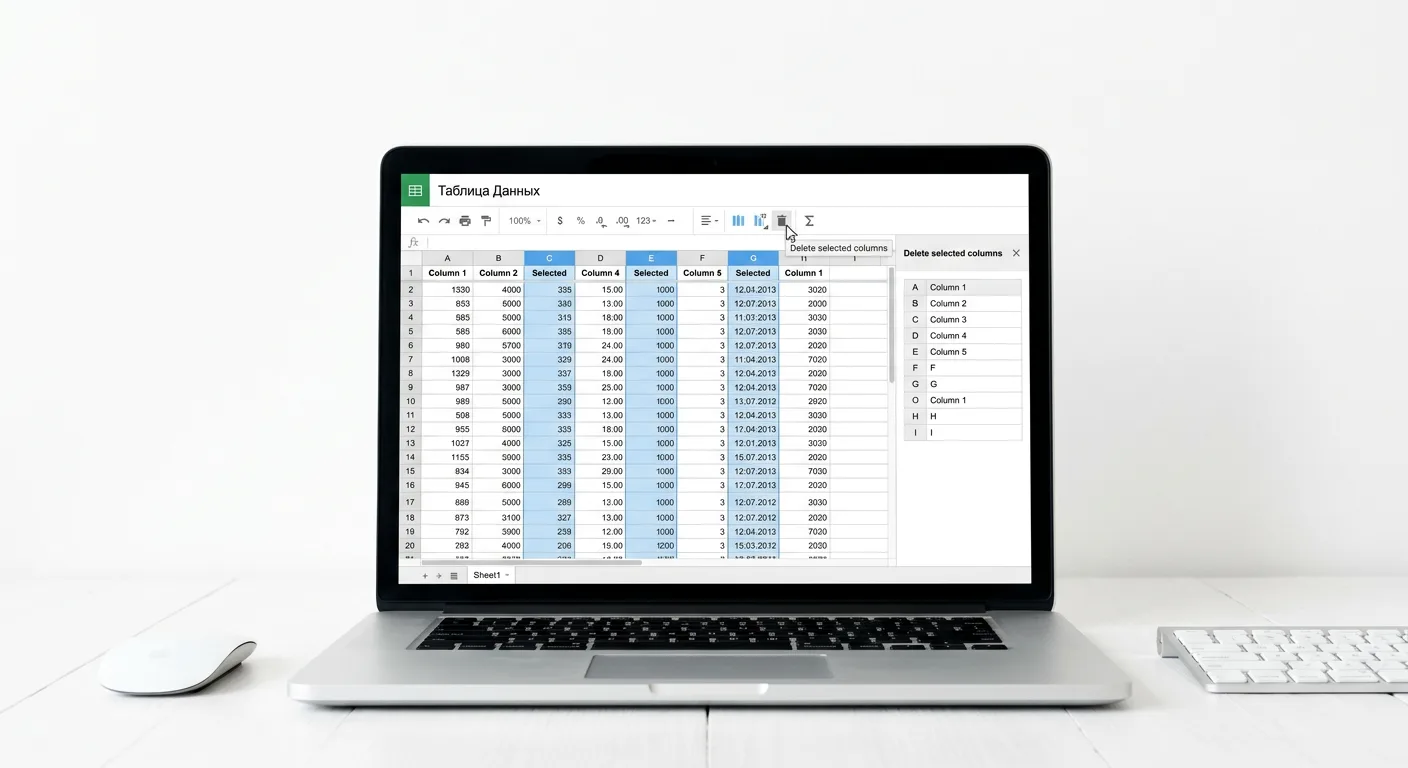
Назначение операции: очистка и нормализация табличных данных
Изменение структуры таблицы путем удаления столбцов напрямую влияет на размерность массива данных. Эта операция позволяет преобразовать исходную широкую выгрузку в более компактную форму. При исключении выбранного вертикального диапазона строка, представляющая собой единую информационную запись, не теряет своей логической целостности. Связь между оставшимися атрибутами внутри каждой отдельной горизонтальной строки полностью сохраняется, что обеспечивает корректность всего последующего цикла обработки.
Процесс очистки данных направлен на избавление массива от информационного шума. В первичных отчетах часто присутствуют системные идентификаторы, технические временные метки или промежуточные вычисления, которые не представляют ценности для конечного пользователя. Исключение таких столбцов оставляет в табличном пространстве только те показатели, которые непосредственно требуются для решения текущей прикладной задачи.
Нормализация табличных данных решает задачу приведения структуры массива к заданному стандарту. Целевые учетные системы, реляционные базы данных или аналитические платформы требуют строго определенного набора метрик. Наличие избыточных вертикальных диапазонов в исходном файле часто приводит к конфликтам при загрузке или инициирует создание мусорных полей в целевой архитектуре.
Удаление нерелевантной информации подготавливает массив к импорту в сторонние среды и решает несколько структурных задач:
- Согласование схемы данных путем приведения структуры исходного файла в точное соответствие с полями принимающей базы.
- Снижение вычислительной нагрузки на интерфейсы приема данных за счет уменьшения общего количества считываемых ячеек.
- Предотвращение сбоев импорта, связанных с попыткой обработки нераспознанных или нетипизированных значений, находящихся в лишних столбцах.
При подготовке датасета к анализу предварительное отсечение избыточных измерений ускоряет процесс агрегации метрик. Очищенный массив требует меньше оперативной памяти при загрузке в инструменты вычислительной статистики и позволяет оперировать исключительно полезными переменными без необходимости программной фильтрации на этапе построения моделей.
Механика исключения столбцов и сдвиг данных
Структура электронной таблицы базируется на двумерной координатной сетке, образованной пересечением вертикальных и горизонтальных векторов. Операция исключения столбца представляет собой изъятие заданного вертикального диапазона ячеек из архитектуры массива. В отличие от очистки содержимого, при которой координатная сетка остается неизменной, а ячейки просто теряют значения, структурное удаление полностью ликвидирует сам вертикальный вектор на всех уровнях таблицы.
Для выполнения операции необходимо определить целевой диапазон. Идентификация столбца, подлежащего удалению, осуществляется двумя способами:
- По заголовку столбца. Метод применяется в массивах, где первая строка содержит текстовые наименования переменных. Идентификация происходит по точному совпадению названия метрики.
- По индексу. Метод использует системную координату вертикального ряда. Индекс представляет собой порядковый номер или буквенное обозначение, определяющее физическую позицию столбца в таблице слева направо.
Изъятие вертикального диапазона формирует разрыв в табличном пространстве. Чтобы сохранить непрерывность структуры и подготовить корректный файл, применяется алгоритм автоматического сдвига данных. После удаления выбранного вектора все столбцы, находящиеся правее образовавшейся пустоты, синхронно смещаются влево на освободившееся место.
Ключевым условием при таком преобразовании сетки является сохранение логических связей внутри горизонтальных записей. Механика сдвига обеспечивает целостность данных за счет следующих принципов:
- Смещение происходит строго по горизонтальной оси для целых вертикальных блоков ячеек.
- Позиции ячеек внутри одной горизонтальной строки остаются неизменными относительно друг друга, за исключением исключенного элемента.
- Атрибуты каждой записи сохраняют корректную привязку к своим первичным ключам, предотвращая смешивание показателей из соседних строк.
В результате автоматического перестроения сетки формируется новый монолитный массив. Индексы оставшихся столбцов пересчитываются согласно их новым позициям, при этом изначальная структура связей между метриками внутри записей полностью сохраняется.
Поддерживаемые форматы и структуры входных данных
Операция исключения вертикальных диапазонов применима к массивам информации, организация которых опирается на строгую табличную логику. Независимо от способа хранения записей в исходном файле, фундаментальный принцип работы с ячейками, строками и столбцами остается универсальным. Если набор данных может быть представлен в виде двумерной сетки координат, к нему применим алгоритм изъятия выбранных векторов.
Входные данные классифицируются на три основные группы в зависимости от их внутреннего синтаксиса и способа разметки:
- Текстовые форматы с разделителями. К этой категории относятся CSV и TSV. В таких файлах столбцы не имеют физических границ, а формируются логически за счет специальных символов разметки, таких как запятые, точки с запятой или знаки табуляции. При обработке каждый разделитель воспринимается как переход к следующей ячейке, что позволяет изолировать и удалить порядковую позицию определенного столбца во всех текстовых строках массива.
- Форматы рабочих книг электронной таблицы. Представлены стандартами XLS, XLSX и ODS. Это нативные табличные структуры, в которых информация изначально распределена по математической сетке координат. Индексы столбцов прописаны в самой архитектуре документа, поэтому операция удаления применяется напрямую к заданным вертикальным диапазонам.
- Разметочные форматы данных. Группа включает HTML, JSON и XML. Подобные файлы используют иерархическую древовидную структуру, узлы, теги или концепцию ключ-значение. Для применения рассматриваемой операции такие структуры интерпретируются как плоская таблица. Одинаковые ключи объектов или однотипные теги выступают в роли столбцов, а вложенные в них значения формируют горизонтальные записи.
Несмотря на существенные технические различия в синтаксисе перечисленных форматов, процесс исключения данных опирается на единую абстрактную модель. Исходный код проецируется на монолитную матрицу, после чего из нее удаляется заданный вертикальный блок. Универсальность этого подхода гарантирует, что структура логических связей между оставшимися переменными будет сохранена корректно при любых совместимых входных данных, будь то лог-файл, выгрузка из базы данных или классическая электронная книга.
Практические сценарии: пустые, дублирующиеся и скрытые столбцы
Необходимость изменения структуры таблицы путем направленного удаления вертикальных диапазонов продиктована задачами подготовки массивов к публикации, анализу или миграции. Практическое применение данной операции базируется на устранении информационного шума и структурных аномалий, которые возникают на разных этапах сбора и хранения данных.
- Оптимизация массива через исключение пустых столбцов. Вертикальные диапазоны без полезных значений часто генерируются как артефакты парсинга, издержки форматирования или ошибки при автоматическом экспорте из систем учета. Удаление пустых столбцов применяется для уменьшения физического веса конечного файла и снижения вычислительной нагрузки на целевые системы, исключая итерации по пустым узлам или ячейкам.
- Устранение дублирующихся столбцов после слияния баз данных. При агрегации нескольких таблиц, использующих общие ключевые идентификаторы, в итоговой матрице формируются идентичные вертикальные срезы. Исключение дубликатов используется для нормализации массива, что предотвращает избыточность информации и гарантирует привязку только уникальных атрибутов к каждой строке.
- Удаление скрытых столбцов при подготовке к экспорту. В нативных форматах электронных таблиц визуальное скрытие ячеек меняет только параметры отображения, оставляя сами данные в архитектуре документа. Физическое исключение таких столбцов необходимо для предотвращения случайной передачи конфиденциальной информации, промежуточных математических вычислений или служебных ключей, которые могут стать видимыми при конвертации файла в плоский текстовый формат.
Каждый из перечисленных сценариев направлен на приведение табличной матрицы к состоянию, пригодному для машинной обработки или безопасной передачи.
| Тип исключаемого столбца | Типичный источник появления в массиве | Практический результат применения операции |
|---|---|---|
| Пустой | Ошибки скриптов сбора данных, артефакты форматирования ячеек | Сокращение размера массива, ускорение чтения файла парсерами |
| Дублирующийся | Операции слияния таблиц, выгрузки из реляционных баз данных | Очистка структуры от избыточных ключей, нормализация данных |
| Скрытый | Применение пользовательских фильтров, наличие промежуточных формул | Обеспечение безопасности при экспорте, удаление лишних метаданных |
Описанные сценарии демонстрируют, что сокращение ширины табличной сетки требуется не только для визуальной эстетики, но и для строгого соответствия требованиям принимающих систем, где наличие лишних разделителей или дублирующихся узлов приводит к критическим ошибкам импорта.
Обработка сложных табличных структур: объединенные ячейки
Процесс исключения вертикальных диапазонов опирается на строгую координатную сетку, где границы данных определяются заголовком столбца. В плоских массивах каждому заголовку соответствует ровно один независимый столбец, что делает идентификацию целевых данных прямолинейной. Однако при работе со сложной версткой, типичной для финансовых отчетов, дашбордов или сводных таблиц, базовая структура сетки часто нарушается. Наличие составных заголовков или ячеек, перекрывающих сразу несколько смежных диапазонов, напрямую влияет на логику выделения и удаления информации.
Главной структурной проблемой при изменении ширины массива выступают горизонтально объединенные ячейки. Такое объединение создает единый блок данных, который физически распределен поверх нескольких столбцов. Если операция удаления применяется к одному из столбцов, пересекающих этот блок, возникает конфликт связей.
Влияние объединенных диапазонов на процесс удаления выражается в следующих структурных рисках:
- Потеря смежной информации: удаление одного столбца, входящего в состав объединенной ячейки, может привести к полному удалению значения, хранящегося во всем блоке.
- Нарушение геометрии массива: частичное удаление составного узла провоцирует непредсказуемое смещение оставшихся данных, из-за чего нарушается координация ячеек в соседних строках.
- Конфликт заголовков: если объединение применено к строке заголовков, становится невозможно точно идентифицировать границы подчиненных столбцов для их изолированного извлечения.
Для корректного удаления вертикального диапазона без потери смежных данных требуется предварительная нормализация сетки. Базовым и обязательным шагом в таких сценариях является операция отмены объединения. Разделение сложных составных блоков на исходные независимые ячейки возвращает массиву стандартную двумерную структуру.
После применения операции отмены объединения каждый столбец снова получает строгие границы. Значение, ранее занимавшее несколько столбцов, обычно помещается в крайнюю левую ячейку разделенного диапазона, а остальные ячейки становятся пустыми. Это позволяет безопасно идентифицировать нерелевантный столбец по его заголовку или индексу и исключить его из массива.
Предварительная отмена объединения гарантирует, что удаление затронет исключительно заданный координатный диапазон. Оставшиеся столбцы корректно сдвигаются влево, закрывая пустоты, при этом сохраняется общая целостность информации в строках, и массив остается пригодным для алгоритмического анализа или загрузки в базы данных.