Преобразование букв в нужный регистр представляет собой операцию пакетной нормализации текстовых массивов. Процесс направлен на приведение символов к единому стандарту написания без изменения самого содержания.
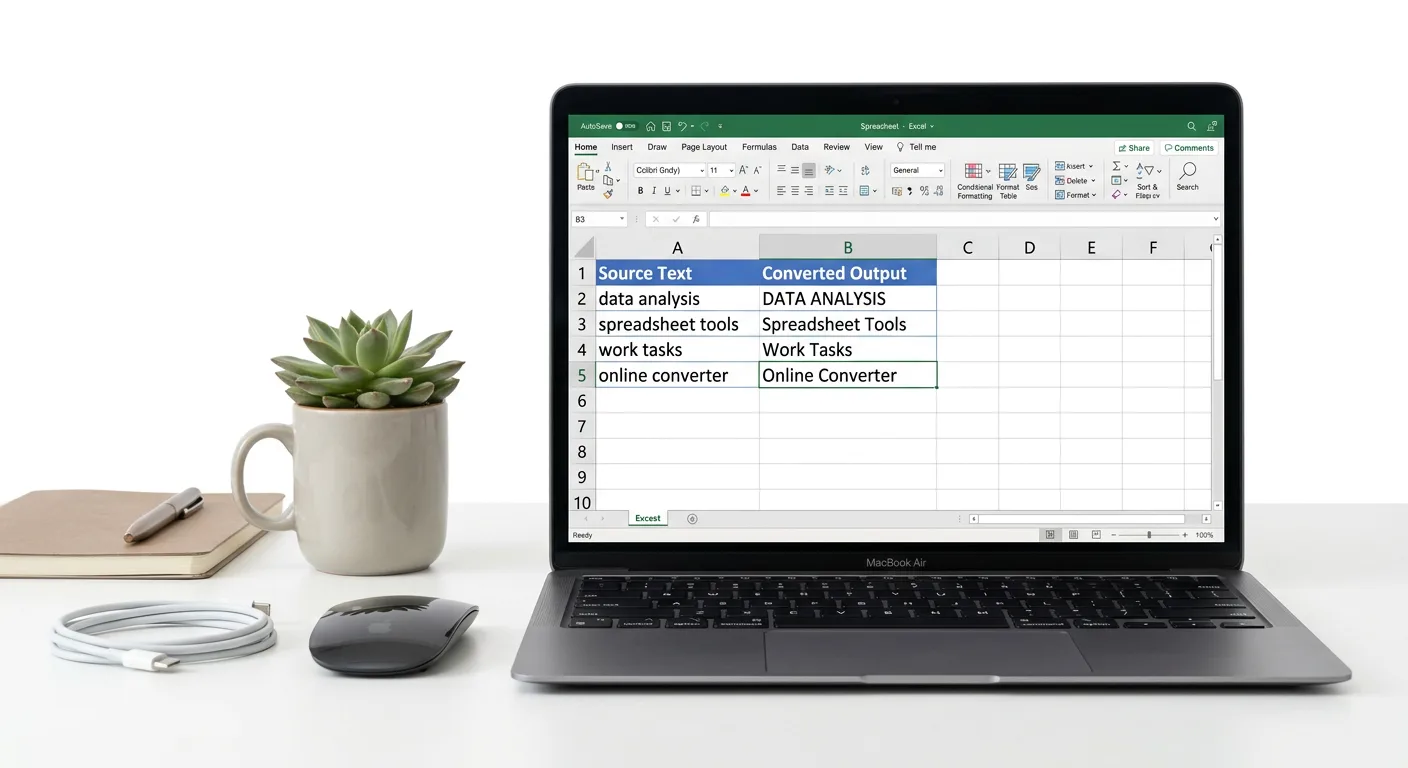
В качестве входных данных используется список строк, скопированный непосредственно из столбца электронной таблицы. Инструмент перехватывает этот вертикальный блок текста и применяет выбранный алгоритм трансформации к каждому элементу независимо. На выходе формируется готовый нормализованный текст с изменённым регистром. Сохранение исходных разделителей строк гарантирует, что вертикальная структура данных останется целостной.
Предварительная обработка текста за пределами основного редактора исключает необходимость написания формул.
Скорректированный массив данных копируется из интерфейса инструмента и вставляется обратно в исходный столбец файла XLSX или CSV. Подготовка данных таким методом предотвращает сбои при последующей сортировке, поиске точных совпадений и удалении дубликатов. Прямая замена значений поверх неформатированного текста ускоряет интеграцию информации, собранной из разных внешних источников.
Базовые алгоритмы преобразования: верхний, нижний и заглавный регистры
Изменение регистра текста базируется на сопоставлении символов по их числовым кодам. Операция преобразует буквенные значения из одного набора в другой согласно таблицам кодировок, не меняя физическую длину строки и порядок следования элементов.
Алгоритм приведения к нижнему регистру
При использовании нижнего регистра (lowercase) каждый буквенный символ строки проверяется на принадлежность к диапазону заглавных букв. Если символ идентифицируется как прописной, алгоритм заменяет его на соответствующий строчный эквивалент. Буквы, которые изначально являлись строчными, пропускаются без изменений. Этот метод формирует полностью однородный текстовый массив, состоящий только из маленьких букв.
Алгоритм приведения к верхнему регистру
Верхний регистр (uppercase) работает на основе обратного сопоставления. Алгоритм сканирует текстовую строку и конвертирует все найденные строчные буквы в прописные. Исходные заглавные символы сохраняют свое изначальное состояние. Результатом выполнения операции становится текст, полностью состоящий из больших букв.
Формат «Каждое Слово С Заглавной Буквы»
Формат Title Case использует логику позиционной обработки букв внутри строки. Процесс конвертации опирается на распознавание границ слов. Алгоритм идентифицирует пробелы как маркеры начала новой лексической единицы.
Первый буквенный символ в начале текстовой строки и первый символ после каждого пробела переводятся в верхний регистр. Все последующие буквы в пределах одного слова принудительно трансформируются в нижний регистр. Такой подход устраняет хаотичное смешанное написание букв внутри слов и приводит текст к стандартизированному заглавному виду.
Обработка небуквенных символов и пунктуации
При математическом преобразовании регистра учитывается наличие символов, не имеющих парных прописных или строчных соответствий в таблице кодировок. К таким элементам относятся:
- Цифры и дроби
- Математические операторы
- Знаки препинания
- Символы пробела и табуляции
- Специальные типографские знаки и валютные символы
При прохождении алгоритма через текстовую строку перечисленные элементы классифицируются как символы без регистра. Правила верхнего, нижнего и заглавного регистров к ним не применяются. Система переносит такие символы в итоговую строку в исходном виде на те же самые позиции. Это гарантирует, что интервалы между словами, числовые значения и пунктуация останутся нетронутыми в процессе текстовой трансформации.
Специфика обработки данных в формате столбца
При работе со списками, скопированными из электронных таблиц, применяется принцип потоковой обработки текстового массива. Ключевым элементом структуры таких данных является символ переноса строки. Этот невидимый маркер выступает в качестве системного разделителя, который обозначает конец одного значения и начало следующего.
Благодаря распознаванию символов переноса строки формируется виртуальный диапазон ячеек. Текстовый блок не сливается в единый абзац, а сохраняет свое разделение на отдельные элементы. Каждая порция текста между переносами строк интерпретируется как самостоятельное значение, точно соответствующее одной ячейке исходного столбца.
Операция изменения регистра применяется к каждой строке массива абсолютно независимо. Конвертация берет первое значение, преобразует его буквы по выбранному правилу, а затем переходит к следующему элементу, не анализируя и не смешивая контекст соседних строк.
Логика обработки вертикального списка опирается на строгую последовательность действий:
- Идентификация системных символов разрыва строки в скопированном массиве текста.
- Разделение сплошного текста на изолированные строки, формирующие виртуальные ячейки.
- Построчное применение математического правила смены регистра к каждому элементу по отдельности.
- Сборка преобразованных значений обратно в единый список с восстановлением исходных разделителей.
Такой механизм независимой потоковой обработки гарантирует полное сохранение исходной вертикальной структуры данных. Количество строк на входе всегда строго совпадает с количеством строк на выходе. Отсутствие смещений, потери строк или случайного склеивания текста позволяет корректно скопировать нормализованный результат и напрямую вставить его обратно в исходный столбец электронной таблицы. Каждое обновленное значение занимает свою исходную позицию без нарушения архитектуры документа.
Соответствие текстовым функциям электронных таблиц (Excel, Р7-Офис)
Результат преобразования массива данных через внешний инструмент полностью идентичен работе классических текстовых формул, встроенных в современные табличные процессоры. Логика изменения регистра опирается на те же математические стандарты кодирования символов, что делает внешнюю нормализацию прямой альтернативой вычислениям внутри самого документа.
Каждому базовому режиму конвертации соответствует конкретная функция электронных таблиц, применяемая для обработки ячеек с текстом:
| Режим преобразования | Функция (русскоязычный интерфейс) | Функция (англоязычный интерфейс) |
|---|---|---|
| Верхний регистр | ПРОПИСН | UPPER |
| Нижний регистр | СТРОЧН | LOWER |
| Каждое слово с заглавной | ПРОПНАЧ | PROPER |
Стандартный подход к изменению регистра внутри самой таблицы требует выполнения промежуточных шагов. Для применения функции ПРОПИСН, СТРОЧН или ПРОПНАЧ необходимо создать дополнительный пустой столбец, написать формулу с ссылкой на первую ячейку, протянуть ее до конца диапазона, а затем скопировать полученный результат. Чтобы избавиться от зависимости от исходных данных, требуется применить специальную вставку значений поверх оригинального столбца, после чего удалить временный вычисляемый столбец.
Внешняя потоковая обработка заменяет этот многоступенчатый процесс. Она исключает необходимость написания формул, выделения места под вычисляемые столбцы и использования специальных режимов вставки. Исходный массив копируется в буфер обмена, проходит конвертацию, после чего готовые нормализованные значения вставляются ровно на те же позиции. Архитектура таблицы при этом не меняется, а риск случайного повреждения соседних формул или нарушения активной фильтрации сводится к нулю.
Специальные режимы: инверсия, чередование и программные форматы
Помимо стандартных преобразований, существуют специфические форматы регистра, не имеющие прямых аналогов среди встроенных функций электронных таблиц. Такие режимы применяются для нормализации нестандартного ввода, стилизации текста или подготовки массивов данных к экспорту в специализированные системы.
Нетиповые текстовые форматы изменяют регистр по алгоритмам, обрабатывающим строку целиком или опирающимся на текущее состояние конкретного символа:
- Регистр предложения (Sentence case) - преобразование, при котором первый буквенный символ всей строки переводится в верхний регистр. Остальные символы, независимо от их изначального состояния, принудительно приводятся к нижнему регистру. Формат позволяет нормализовать связный текст, фрагменты описаний или комментарии, где требуется классическое оформление предложений.
- Инверсия регистра (Inverse case) - зеркальное изменение состояния каждой буквы. Строчные символы становятся прописными, а прописные - строчными. Данная математическая операция наиболее востребована при массовом восстановлении текста, набранного с ошибочно активированным режимом Caps Lock, без необходимости ручного перепечатывания.
- Чередующийся регистр (Alternating case) - алгоритм последовательной смены верхнего и нижнего регистра для каждой буквы в строке. При формировании визуального чередования небуквенные символы и пробелы обычно не прерывают общую последовательность.
Программные форматы составных строк
Особую категорию составляют форматы, применяемые в программировании, веб-разработке, разметке баз данных и при формировании системных идентификаторов. При конвертации в такие режимы алгоритм не только меняет размер букв, но и модифицирует архитектуру самой строки: удаляет пробелы и применяет предметные правила объединения слов.
| Формат | Логика формирования | Пример преобразования |
|---|---|---|
| camelCase | Пробелы удаляются. Первое слово начинается со строчной буквы, каждое последующее слово в строке - с заглавной. |
account billing status
➔
accountBillingStatus
|
| snake_case | Все буквы переводятся в нижний регистр. Пробелы заменяются символом нижнего подчеркивания. |
user target group
➔
user_target_group
|
| kebab-case | Все буквы приводятся к нижнему регистру. В качестве разделителя слов вместо пробелов используется дефис. |
header background color
➔
header-background-color
|
| SCREAMING_SNAKE_CASE | Все буквы переводятся в верхний регистр. Словесные интервалы заполняются нижним подчеркиванием. |
max limit value
➔
MAX_LIMIT_VALUE
|
Применение программных форматов к столбцу электронных таблиц позволяет быстро сгенерировать валидные ключи, переменные или названия файлов из обычного текстового списка, исключая синтаксические ошибки при последующем импорте данных в код.
Практические сценарии нормализации текстового контента
Приведение текстовых массивов к единому стандарту написания является обязательным этапом подготовки данных перед их импортом в базы данных, учетные системы или аналитические платформы. Разнобой в размерах букв усложняет визуальное восприятие информации и приводит к ошибкам при автоматической машинной обработке таблиц. Выбор целевого текстового формата напрямую зависит от типа обрабатываемой информации.
| Тип данных | Применяемый формат | Входное значение | Результат нормализации |
|---|---|---|---|
| Имена собственные (ФИО, названия) | Заглавный регистр |
иванов петр сергеевич
|
Иванов Петр Сергеевич
|
| Артикулы, промокоды, аббревиатуры | Верхний регистр |
sku-459-x
|
SKU-459-X
|
| Адреса электронной почты, логины | Нижний регистр |
Alex.Smith@Company.Com
|
alex.smith@company.com
|
Списки физических лиц, выгруженные из веб-форм обратной связи или собранные вручную, часто содержат хаотичное распределение строчных и прописных символов. Применение заглавного регистра позволяет быстро восстановить формализованный вид имен и фамилий на протяжении всего столбца.
Учетные номенклатуры, аббревиатуры и складские артикулы традиционно приводятся к прописным буквам. Конвертация в верхний регистр визуально выделяет системные ключи в массиве текста и предотвращает путаницу между визуально похожими символами. В противоположность этому, контактные данные, системные теги и адреса электронной почты стандартизируются через приведение к строчным буквам. Серверные системы маршрутизации и модули авторизации часто обладают чувствительностью к регистру, поэтому наличие непрогнозируемых заглавных букв в email-адресе или логине может заблокировать доступ или нарушить доставку сообщений.
Влияние регистра на табличные вычисления
Синтаксическая идентичность строк критически важна при выполнении реляционных операций внутри массива. Математические алгоритмы электронных таблиц при строгом сравнении воспринимают одну и ту же букву в разных регистрах как два независимых символа с разными кодировками. Предварительная нормализация контента обеспечивает корректное выполнение базовых процедур очистки и анализа:
-
Поиск точных совпадений: функции вертикального сопоставления и индексного поиска работают без ошибок только с абсолютно идентичными строками. Если эталонное искомое значение имеет вид
PROMO-2024, а в проверяемом массиве указаноPromo-2024, алгоритм вернет ошибку отсутствия данных. -
Удаление дубликатов: стандартные табличные инструменты дедупликации пропустят строки
msc-branchиMsc-Branch, расценив их как уникальные. Это приведет к задвоению записей и искажению итоговой статистики. Приведение всего столбца к одному текстовому стандарту позволяет алгоритмам очистки безошибочно выявлять и удалять повторяющиеся ячейки.