Отбор строк по заданным значениям представляет собой базовую операцию автоматизированного извлечения записей из табличных массивов. Инструмент решает прикладную задачу точной фильтрации исходного набора данных на основе совпадения с критерием, который задает пользователь. Процесс исключает ручной поиск и предотвращает пропуск релевантных элементов при работе с объемными выгрузками.
Система загружает текстовый массив, применяет заданное условие к выбранному столбцу и генерирует новую структуру. Исходный набор данных при этом не модифицируется.
Базовый алгоритм преобразования строится на последовательном логическом сопоставлении. Программный механизм изолирует целевой столбец и валидирует каждую ячейку на предмет соответствия искомому параметру. Результатом выполнения становится генерация независимого массива, который содержит исключительно те строки, где заданное условие выполнилось. Эта процедура выступает критическим этапом предварительной подготовки сырой информации к последующему анализу.
В качестве входных данных принимается структурированный текст, включая файлы CSV. Итоговая выборка полностью наследует оригинальную разметку заголовков и готова к немедленному экспорту для продолжения вычислений.
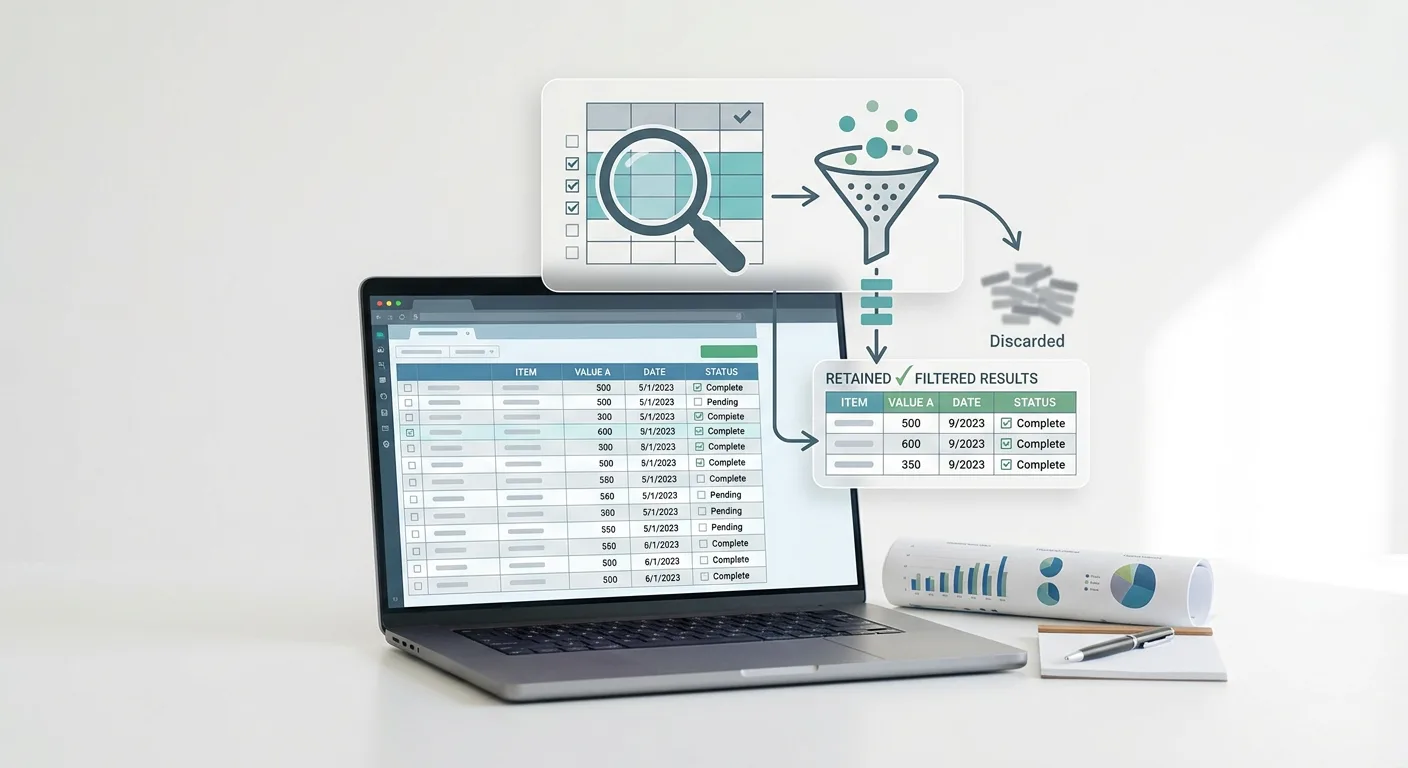
Алгоритм обработки таблиц и индексация столбцов
Табличный массив представляет собой двумерную структуру данных, состоящую из строк и столбцов. Для точного позиционирования проверяемой информации применяется система индексации. Верхняя строка текстового массива обычно выступает в роли заголовка, который присваивает логические идентификаторы каждому столбцу. При отсутствии строки заголовка обращение к целевому столбцу осуществляется по его порядковому числовому индексу. Пересечение конкретной строки и выбранного столбца образует ячейку, содержимое которой выступает объектом для проверки.
Математический и логический принцип построчной фильтрации базируется на последовательной итерации. Вычислительный процесс представляет собой линейный обход всего набора данных. Алгоритм начинает работу с первой записи после заголовка и последовательно перемещается вниз до конца документа, не пропуская ни одного элемента.
Цикл обработки каждой отдельной строки состоит из строгой последовательности действий:
- Временная изоляция текущей строки из общего текстового массива.
- Определение координат целевой ячейки внутри выделенной строки на основе заданного индекса или имени столбца.
- Извлечение фактического содержимого изолированной ячейки для проведения анализа.
- Выполнение операции сравнения извлеченного значения с параметром, который требуется найти.
Результатом логического сопоставления на финальном этапе цикла всегда является булево значение. Алгоритм возвращает однозначный бинарный ответ, который определяет дальнейшую судьбу всей проверяемой строки, а не только отдельной ячейки.
Интерпретация булевых значений при формировании нового массива подчиняется следующим правилам:
| Результат логической операции | Фактическое условие | Действие над строкой массива |
|---|---|---|
| True (Истина) | Содержимое целевой ячейки отвечает заданному критерию совпадения | Вся строка целиком включается в итоговую выборку с сохранением исходной структуры |
| False (Ложь) | Содержимое целевой ячейки не совпадает с искомым параметром | Строка полностью игнорируется и не переносится в результирующий массив данных |
Таким образом, механизм построчной фильтрации работает как строгий логический вентиль. Операция применяется независимо к каждой строке, что гарантирует точное извлечение записей без искажения связей между ячейками внутри самой строки.
Структура входных данных: CSV, TSV и форматирование
Для корректного извлечения строк исходный текстовый массив должен иметь предсказуемую и однородную структуру. Операция отбора значений применима к стандартным форматам хранения табличных данных, среди которых основными являются CSV, TSV и структурированные TXT-файлы.
Фундаментальным требованием к исходному файлу является наличие консистентных разделителей. Разделитель действует как маркер границы при разбиении единой текстовой строки на массив изолированных ячеек. В зависимости от формата применяются следующие разделители:
- В файлах CSV столбцы отделяются друг от друга запятыми или точками с запятой.
- В формате TSV для разделения ячеек используется невидимый символ табуляции.
- В пользовательских TXT-документах может применяться специальный строго определенный знак.
Нарушение структуры разделителей является критической ошибкой входных табличных данных. Если в одной из строк количество разделителей меньше или больше, чем в остальных, алгоритм не сможет корректно рассчитать индексы ячеек. Это приводит к смещению данных, из-за чего логическая проверка будет выполняться по содержимому смежных столбцов, возвращая некорректный результат.
При обработке текстового файла учитывается наличие пустых полей. Два разделителя, идущие подряд без текстовых или числовых символов между ними, интерпретируются при парсинге как существующая ячейка с пустым значением. При логическом сопоставлении с конкретным искомым параметром такая ячейка возвращает значение False, и вся строка исключается из итоговой выборки.
Настройка операции отбора требует точного указания целевого столбца. Метод определения координат напрямую зависит от визуальной и логической структуры загруженного документа:
| Структура документа | Способ адресации столбца | Особенности применения |
|---|---|---|
| Наличие строки заголовка | Текстовый идентификатор (имя) | Первая строка обрабатывается как словарь имен столбцов. Для поиска ячейки указывается точное текстовое название из заголовка. |
| Отсутствие строки заголовка | Числовой индекс | Все строки воспринимаются как массив данных. Навигация осуществляется исключительно по порядковому номеру столбца слева направо. |
Отсутствие выделенной строки заголовков делает невозможным обращение к данным по именам. В таких случаях использование числовой индексации становится обязательным условием для изоляции ячеек и применения критерия сравнения к нужному сегменту массива.
Критерии совпадения: точные значения, подстроки и регистр
После изоляции ячейки в целевом столбце выполняется логическая проверка ее содержимого на соответствие заданному пользовательскому параметру. Успешность этой операции зависит от выбранного критерия сопоставления, который устанавливает математические и текстовые правила сравнения извлеченных данных с искомой строкой.
Точное совпадение
Критерий точного значения требует стопроцентной идентичности данных в ячейке и заданного параметра. При таком условии логический оператор проверяет длину строки и каждый символ в ней. Любое расхождение, включая лишние пробелы в начале или конце текста, невидимые символы табуляции или разные форматы разделителей, приведет к возврату значения False.
Точное сопоставление применяется при извлечении строк по строгим идентификаторам, числовым артикулам, уникальным кодам или стандартизированным меткам, где частичные совпадения могут исказить итоговую выборку.
Поиск по подстроке
При обработке вариативных текстовых данных полная идентичность часто избыточна или невозможна. Для таких задач применяются правила частичного совпадения, которые анализируют вхождение искомого фрагмента (подстроки) в состав более длинной строки. Настройка позиционирования подстроки определяет гибкость фильтрации:
- Содержит: искомая последовательность символов может находиться в любой позиции внутри ячейки. Логика сканирует всю строку на наличие заданного блока.
- Начинается с: проверка жестко привязана к первому символу ячейки. Массив данных сопоставляется с искомым значением только с левого края, образуя поиск по префиксу.
- Заканчивается на: логическое сравнение применяется исключительно к последним символам ячейки (поиск по суффиксу).
Смещение фокуса с точного значения на позиционную подстроку позволяет группировать данные по общим признакам, игнорируя уникальную часть содержимого ячейки.
Чувствительность к регистру
При сопоставлении любых буквенно-цифровых данных критически важным параметром выступает учет регистра. В вычислительной логике заглавные и строчные буквы имеют разные числовые коды, поэтому их обработка требует явного указания правил сравнения.
| Режим сравнения | Принцип обработки | Результат логической проверки |
|---|---|---|
| Строгий учет регистра (Case-sensitive) | Символы в разных регистрах интерпретируются как совершенно разные значения. Проверяется абсолютное соответствие кодировки символов. | Слово "Статус" не будет равно слову "статус". Строка исключается из выборки. |
| Регистронезависимость (Case-insensitive) | Разница между прописными и строчными буквами игнорируется. Содержимое приводится к единому базису перед сопоставлением. | Значения "Статус", "СТАТУС" и "статус" признаются идентичными. Строка добавляется в выборку. |
Использование регистронезависимого сравнения компенсирует несогласованное форматирование в исходных текстовых таблицах и предотвращает потерю релевантных строк из-за случайных нажатий Caps Lock или отсутствия стандартизации при вводе данных.
Практические сценарии извлечения записей
Операция построчного отбора применяется для сегментации массивов данных в различных предметных областях. Выделение специфических записей позволяет изолировать целевую информацию из объемных исходных файлов. Ниже представлены типовые примеры обработки таблиц на основе заданных условий совпадения.
Анализ транзакций
- Входные данные: Выгрузка финансовых операций, содержащая столбцы с идентификаторами платежей, датами, суммами и текущими статусами.
- Применяемое правило: Поиск точного совпадения текстового условия со значением "Отклонено" в целевом столбце статусов.
- Ожидаемый результат: Формирование изолированного массива, состоящего исключительно из неудачных платежей. Полученная выборка используется для выявления причин отказов, аудита или сверки с биллинговой системой.
Сегментация товарного прайс-листа
- Входные данные: Объемный CSV файл с номенклатурой магазина, включающий артикулы, наименования, цены, складские остатки и категории товаров.
- Применяемое правило: Сопоставление по заданному значению в столбце "Категория" для извлечения определенной группы номенклатуры.
- Ожидаемый результат: Выделение строк, описывающих товары только одной целевой категории. Изолированный набор записей применяется для локального обновления цен, проведения инвентаризации или подготовки фрагмента базы данных для внешних платформ.
Обработка журналов событий сервера
- Входные данные: Журнал регистрации в формате TSV, где построчно фиксируются временные метки, IP-адреса, запрошенные ресурсы и коды ответа сервера.
- Применяемое правило: Проверка совпадения позиционной подстроки с условием "начинается с" в столбце IP-адресов. В качестве искомого значения выступает префикс конкретной подсети.
- Ожидаемый результат: Извлечение всех записей и сетевых запросов, сгенерированных узлами из заданного сегмента сети. Подобная выборка необходима для расследования инцидентов безопасности, анализа локального трафика или аудита активности конкретного пула адресов.
Формирование результата и экспорт выборки
После завершения построчной проверки формируется итоговый набор данных. Данная операция носит неразрушающий характер, что означает полное сохранение исходного табличного массива в его изначальном виде. Вместо модификации оригинала происходит генерация нового независимого массива. Все строки, которые не соответствуют заданным критериям и возвращают при проверке логическое значение False, отсеиваются и не попадают в результат.
Ключевой характеристикой сгенерированной выборки является строгая преемственность форматов. Изолированный массив полностью сохраняет оригинальную структуру столбцов, их последовательность и форматирование ячеек. Если исходные данные включали строку заголовка, она без изменений переносится в результирующий набор. Это исключает смещение данных и гарантирует, что значения останутся привязаны к своим изначальным атрибутам и переменным.
Готовая выборка отфильтрованных строк предназначена для дальнейшего использования в аналитических или учетных процессах. Доступны следующие варианты извлечения полученного результата:
- Экспорт в формате CSV. Сформированный массив выгружается в виде валидного текстового файла. В нем сохраняются корректные разделители и экранирование символов, что позволяет без дополнительных преобразований импортировать результат в базы данных или BI-системы.
- Копирование в буфер обмена. Текстовый блок с релевантными строками переносится в оперативную память устройства. Этот метод применяется для быстрой вставки очищенных данных в редакторы электронных таблиц, такие как Excel, с возможностью последующего локального анализа и сохранения документа в формате XLSX.