Единый формат даты для обработки данных требуется для корректной работы аналитических систем и баз данных. Нормализация временных значений представляет собой обязательный этап предобработки (Data Preparation). Инструмент преобразует различные исходные представления времени в строго заданный целевой формат. Это немедленно устраняет проблему структурной разнородности входящей информации.
Входными данными служат строковые и числовые значения, выгруженные из различных источников, включая файлы CSV, JSON или XML. Часто такие массивы содержат конфликтующую логику записи. Сервис считывает разрозненные временные метки и приводит их к общему стандарту. Готовый результат представляет собой нормализованный набор данных. Программные алгоритмы и базы данных интерпретируют такие значения однозначно, что исключает сбои при неявном преобразовании типов на стороне сервера.
Процесс перевода сырых сведений в стандартизированный вид делает массивы полностью пригодными для точной хронологической сортировки и дальнейших вычислений.
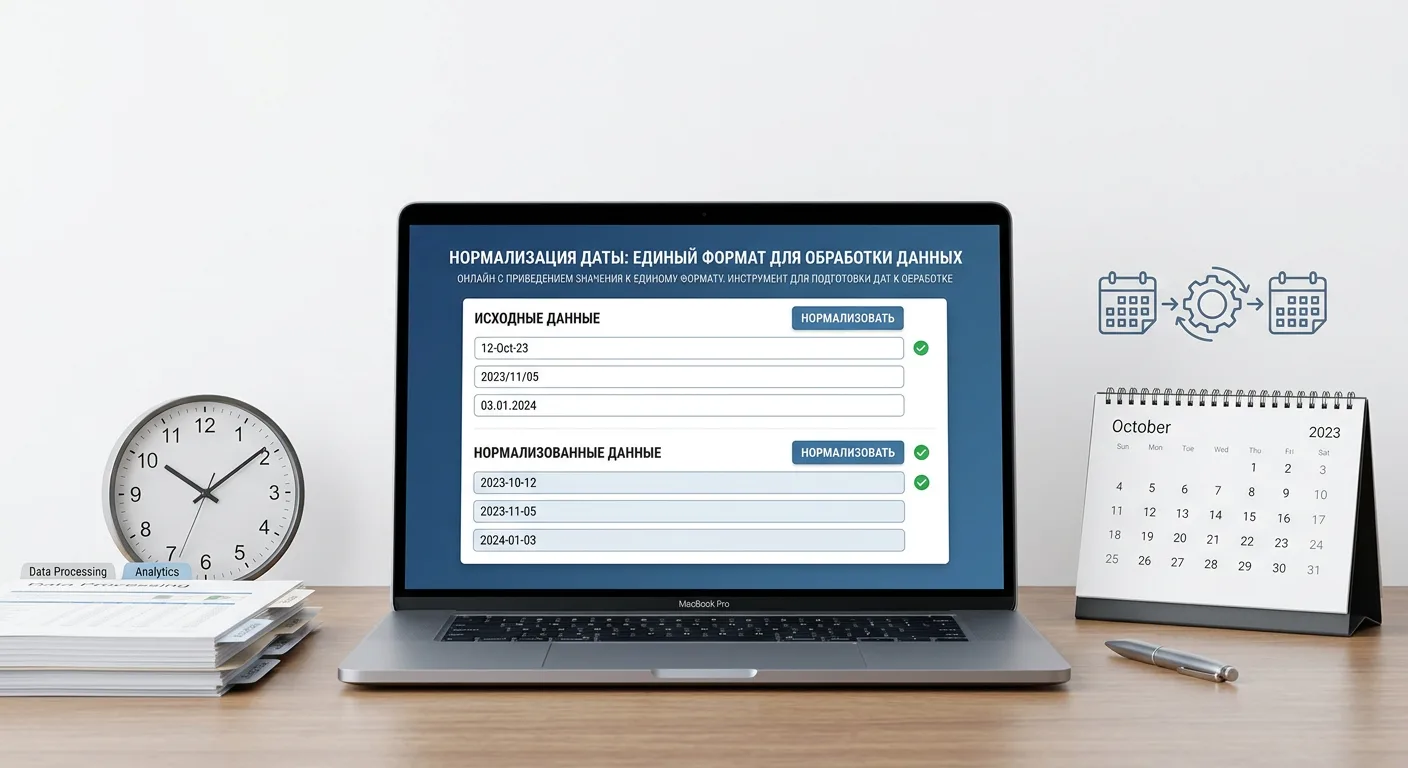
Проблема смешанных форматов и неоднозначности входных данных
При объединении информации из нескольких независимых источников часто возникают смешанные форматы дат. В одном массиве данных могут одновременно присутствовать записи, сгенерированные разными системами учета, пользователями или программными интерфейсами. Отсутствие строгой типизации на этапе сбора приводит к тому, что хронологическая информация сохраняется в непредсказуемом виде.
Исходные значения глобально разделяются на текстовый формат и числовой формат. Текстовый формат представляет собой строку символов, удобную для визуального восприятия человеком, но требующую алгоритмического разбора перед вычислениями. Числовой формат выражает время математически, однако без знания исходной точки отсчета или размерности такие значения не могут быть напрямую сопоставлены со строковыми записями.
Конфликт порядков записи и неоднозначные даты
Наибольшую угрозу для целостности данных представляют неоднозначные даты. Эта логическая уязвимость возникает из-за физического совпадения допустимых числовых диапазонов для дней и месяцев. Классическим примером такого конфликта является различие между американским и европейским стандартами записи.
В системе US format применяется порядок MM/DD/YYYY, тогда как UK date format опирается на последовательность DD/MM/YYYY. При чтении строки «05/04/2023» без дополнительного структурного контекста невозможно достоверно определить, означает ли запись 4 мая или 5 апреля. В рамках обработки ненормализованных массивов данных такая неоднозначность приводит к критическим искажениям в статистике, неправильным расчетам интервалов и нарушению хронологической сортировки.
Сложности программного распознавания строковых значений
Помимо прямого конфликта региональных стандартов, программный парсинг усложняется высокой вариативностью синтаксиса внутри текстовых представлений. Извлечение корректных хронологических компонентов затрудняется следующими структурными аномалиями:
- Различные разделители: источники могут применять точки, слеши, дефисы или пробелы в качестве границ между днем, месяцем и годом. Внутри одного столбца могут встречаться записи вида «12.10.2023» и «12-10-2023».
- Текстовые названия месяцев: использование буквенных обозначений вместо числовых требует учета языковой локализации и регистра. Сокращенные формы, полные названия и опечатки делают невозможным прямое математическое сравнение строк.
- Двузначные годы: запись года двумя цифрами создает проблему идентификации столетия. Значение «50» может быть интерпретировано как 1950 или 2050 год, что требует внедрения дополнительных логических условий при обработке исторических или прогностических выборок.
Парсинг и преобразование строки в дату
Для преодоления структурных аномалий и неоднозначности исходного текста применяется процедура парсинга. В контексте обработки временных рядов парсинг представляет собой синтаксический анализ входного значения, при котором сплошной текст разбивается на логические хронологические компоненты. Базовой операцией на данном этапе выступает преобразование строки в дату (СтрокаВДату). Этот процесс переводит неструктурированные символы в типизированные данные, пригодные для машинного вычисления.
Извлечение корректных значений из текста осуществляется с помощью шаблонов форматирования. Шаблон действует как структурная маска, которая накладывается на исходную строку. Он состоит из спецификаторов формата - служебных символов, указывающих алгоритму чтения, какой именно компонент времени находится в конкретной позиции. Использование спецификаторов позволяет абстрагироваться от типа разделителей и извлекать только нужную хронологическую информацию.
Основными строительными блоками шаблонов выступают токены форматирования. При обработке стандартных календарных записей чаще всего применяются следующие токены:
| Токен форматирования | Назначение спецификатора | Ожидаемое входное значение |
|---|---|---|
| YYYY | Идентификация полного значения года | Четыре цифры (например, 2023) |
| MM | Идентификация месяца с ведущим нулем | Две цифры (от 01 до 12) |
| DD | Идентификация дня месяца с ведущим нулем | Две цифры (от 01 до 31) |
Применение шаблона определяет строгий порядок чтения элементов. Если входная строка имеет вид «2023/10/12», а применяется маска вида «YYYY/MM/DD», система безошибочно сопоставит первые четыре символа с годом, символы между слешами - с месяцем, а последние символы - с днем. Такое прямое сопоставление исключает ошибки сдвига позиций.
Успешность преобразования строки в дату напрямую зависит от региональных настроек (локализации). Локализация влияет на интерпретацию исходной строки до момента ее окончательного приведения к целевому стандарту. При наличии текстовых представлений месяцев именно языковой контекст определяет, к какому словарю будет обращаться парсер для преобразования буквенного значения в числовой эквивалент. Также локализация помогает разрешить структурную неоднозначность коротких числовых записей, задавая приоритетный порядок чтения токенов в случаях, когда исходные данные не имеют явных признаков принадлежности к определенному формату.
Стандарт ISO 8601 как универсальный целевой формат
После успешного чтения и интерпретации исходных значений следующим шагом является формирование результирующей строки. Международный стандарт ISO 8601 выступает универсальным форматом для сохранения полученных данных. Его основная задача заключается в устранении любых разночтений при обмене временной информацией между различными информационными системами, базами данных и языками программирования.
Базовая структура записи даты по стандарту ISO 8601 имеет вид YYYY-MM-DD. В рамках веб-технологий и передачи данных через API также широко применяется стандарт RFC 3339, который является профилем ISO 8601 и определяет формат передачи полной временной метки с учетом времени. Типичная строка в формате RFC 3339 выглядит как YYYY-MM-DDTHH:mm:ss.sssZ. В этой записи литерал T выступает строгим разделителем между датой и временем, а символ Z указывает на привязку к нулевому меридиану.
Детерминированность данных при использовании таких форматов обеспечивается несколькими жесткими структурными правилами:
- Использование четырехзначного значения года исключает проблемы интерпретации двузначных записей, жестко фиксируя столетие и предотвращая сдвиги при обработке исторических или будущих данных.
- Обязательное наличие ведущих нулей для месяцев и дней гарантирует постоянную длину компонентов строки. Месяц и день всегда занимают по две позиции, даже если представляют собой однозначные числа (например, 04 вместо 4). Фиксация длины обеспечивает предсказуемую работу парсеров и алгоритмов посимвольного чтения.
- Строгий порядок от старшего компонента к младшему формирует логическую иерархию записи: сначала идет год, затем месяц, затем день.
Расположение компонентов от наибольшего периода к наименьшему имеет решающее математическое и программное значение. При таком подходе лексикографическая сортировка текстовых строк полностью совпадает с хронологической сортировкой дат. Вычислительной системе достаточно сравнить две строки посимвольно слева направо, чтобы безошибочно определить, какое событие произошло раньше, не выполняя сложных математических преобразований.
Приведение разнородных исходных записей к стандартизированному виду YYYY-MM-DD полностью исключает ошибки неявного преобразования. Системы управления базами данных и скрипты обработки воспринимают такую строку однозначно, без попыток применить локальные настройки операционной системы или угадать порядок следования дней и месяцев. Отсутствие двусмысленности является обязательным условием для обеспечения целостности информации на этапе подготовки и нормализации данных.
Нормализация в числовые временные метки (UNIX Timestamp)
Помимо приведения исходных данных к строковым стандартам, отдельным сценарием этапа Data Preparation является преобразование дат в строгие числовые значения. Если стандартизированные строки удобны для визуального контроля и посимвольного чтения, то для программных вычислений и низкоуровневого хранения в базах данных требуется более компактный формат. Перевод строкового представления времени в непрерывное число позволяет вычислительным системам обрабатывать хронологическую информацию без учета сложной логики календарей, високосных годов и переменной длины месяцев.
Общепринятым стандартом числового представления является концепция UNIX-времени. Данная система описывает время не как набор компонентов года, месяца и дня, а как единственную скалярную величину. Отсчет ведется от строго фиксированной точки на временной оси, известной как POSIX-эпоха. Эта стартовая координата соответствует 00:00:00 UTC 1 января 1970 года. Любая метка UNIX Timestamp выражает точное количество времени, прошедшее с этого момента, формируя универсальную шкалу, независимую от региональных особенностей летоисчисления.
При нормализации данных в числовой формат результат формируется в одном из двух основных масштабов, выбор которого зависит от требований целевой системы к точности:
- Временная метка в секундах представляет собой классический формат, применяемый в серверных архитектурах, операционных системах и традиционных реляционных базах данных. Для хранения текущих дат в этом формате достаточно стандартного десятизначного целого числа.
- Временная метка в миллисекундах обеспечивает более высокую гранулярность за счет добавления трех порядков точности. Данный формат является нативным для ряда сред выполнения, включая движки JS, и обязателен при подготовке данных для телеметрии или систем, где важна фиксация событий с долями секунды.
Использование числовых меток времени кардинально оптимизирует архитектуру хранения. Целочисленный тип данных занимает меньше дискового пространства и оперативной памяти по сравнению с текстовыми строками. Индексирование числовых полей в базах данных происходит значительно быстрее, обеспечивая высокую производительность при обработке масштабных массивов информации и подготовке пайплайнов для машинного обучения.
Нормализация часовых поясов и приведение к UTC
При объединении данных из распределенных источников приведение значений к числовому или стандартизированному строковому виду решает только часть задачи. Если исходные временные метки записаны в локальном времени, они отражают региональные настройки, а не абсолютную позицию на глобальной временной шкале. Для устранения этой неоднозначности применяется нормализация UTC.
Нормализация UTC представляет собой процесс преобразования локального времени с учетом смещения часового пояса в единое всемирное координированное время. В технических системах UTC, а также аналогичный ему стандарт GMT, выступают в роли универсального базового ориентира. Пересчет всех входящих дат в эту единую систему координат исключает зависимость данных от географического расположения источника.
Главная проблема смешанных часовых поясов заключается в рассинхронизации при слиянии массивов информации. Если один сервер фиксирует события в зоне CET, а другой работает в зоне EET, прямое сопоставление их локальных временных меток приведет к нарушению реальной последовательности событий. Два действия, произошедшие одновременно в разных регионах, получат разные локальные отметки времени. Без компенсации регионального сдвига корректный анализ таких данных невозможен.
Процесс приведения к базовому времени основывается на извлечении информации о смещении из исходных данных и математическом применении этого сдвига для возврата к нулевой отметке. Если исходная система указывает положительное смещение, при нормализации это значение вычитается из локального времени. При отрицательном смещении разница прибавляется.
Примеры преобразования региональных значений в эквивалентную координату UTC демонстрируют логику устранения временных сдвигов при подготовке данных:
| Исходное локальное время и смещение | Зона | Результат нормализации UTC |
|---|---|---|
| 15:30:00+03:00 | EET | 12:30:00Z |
| 14:30:00+02:00 | CET | 12:30:00Z |
| 07:30:00-05:00 | EST | 12:30:00Z |
Единое временное пространство необходимо для корректного связывания информации. Приведение всех записей к стандарту UTC выравнивает датасеты в следующих сценариях обработки:
- Агрегация системных журналов и логов приложений с серверов, физически распределенных по разным континентам.
- Консолидация транзакций из региональных баз данных в единое хранилище.
- Сбор и выравнивание показателей телеметрии с распределенной сети датчиков, отправляющих данные в собственных локальных часовых поясах.
Практическое применение нормализованных дат
После устранения неоднозначности форматов и региональных сдвигов массив данных становится пригодным для алгоритмической обработки. Приведение временных меток к единому стандарту является обязательным условием для выполнения математических, логических и аналитических операций над датасетами.
Хронологическая сортировка массивов данных
Организация записей во временном порядке требует детерминированного формата исходных значений. Использование текстового представления, в котором элементы располагаются строго от старшего к младшему, кардинально упрощает этот процесс.
При использовании структуры YYYY-MM-DD строковое (лексикографическое) сравнение полностью совпадает с хронологическим порядком. Вычислительным системам и базам данных не требуется предварительно конвертировать текст во внутренние объекты даты при выполнении запросов. Посимвольное сравнение слева направо автоматически выстраивает записи от самых старых к самым новым, что обеспечивает высокую скорость сортировки таблиц и лог-файлов.
Вычисление интервалов между датами
Унифицированное представление времени позволяет выполнять точные математические расчеты длительностей. Операция вычисления интервала требует уверенности в том, что обе сравниваемые точки используют идентичную шкалу измерения и не содержат скрытых смещений.
Разница между двумя нормализованными метками применяется для решения следующих практических задач:
- Определение точного времени отклика серверной архитектуры между поступлением запроса и генерацией ответа.
- Расчет продолжительности пользовательских сессий в аналитических системах.
- Вычисление возраста когорт пользователей от даты регистрации до текущего момента.
- Измерение задержек на различных этапах логистических цепочек.
Извлечение признаков (Feature Engineering)
В задачах машинного обучения полные метки времени редко передаются в модели в исходном виде. Нормализованное поле даты служит надежным фундаментом для извлечения новых независимых переменных, которые помогают алгоритмам находить скрытые временные закономерности и циклы.
Процесс Feature Engineering подразумевает разделение единой метки на изолированные компоненты, которые описывают контекст события. Наличие стандартизированной структуры гарантирует, что алгоритм парсинга отработает без сбоев на всей выборке.
Типичные признаки, формируемые на основе нормализованной даты для обогащения датасетов:
| Извлекаемый признак | Тип данных признака | Практическая цель в аналитике |
|---|---|---|
| День недели | Числовой (от 1 до 7) | Выявление колебаний пользовательской активности между буднями и выходными. |
| Месяц или квартал | Категориальный | Анализ сезонности, прогнозирование продаж или нагрузки на инфраструктуру. |
| Час совершения события | Числовой (от 0 до 23) | Кластеризация аудитории и выявление пиковых часов нагрузки на сервера. |
| Индикатор выходного дня | Булево значение (0 или 1) | Корректировка прогнозов систем рекомендаций с учетом свободного времени пользователей. |
Точность извлечения подобных признаков напрямую зависит от качества предварительной подготовки данных. Только после того как все исходные строки приведены к единому синтаксическому и временному знаменателю, результаты классификации и прогнозирования становятся достоверными.