Очистка структуры от выбранных полей представляет собой технический процесс фильтрации текстовых данных формата JSON. Эта направленная операция позволяет исключить из исходного кода конкретные ключи и строго связанные с ними значения. Пользователь передает во входные параметры массив или объект, указывает целевые свойства для удаления и получает перестроенную схему. Исходные типы данных для нетронутых элементов остаются без изменений.
Избыточные узлы перегружают файлы. Удаление ненужных свойств решает три практические задачи: подготовка ответов сервера, оптимизация физического размера полезной нагрузки и безопасная передача информации. Исходный код часто содержит внутренние идентификаторы, токены, скрытые параметры или системные метки. Их необходимо физически вырезать перед отправкой на сторону клиента. Трансформация происходит непосредственно на уровне пар ключ-значение.
Инструмент обрабатывает как плоские списки, так и сложные иерархические деревья с глубокой вложенностью. Синтаксическая целостность формата после удаления узлов полностью сохраняется.
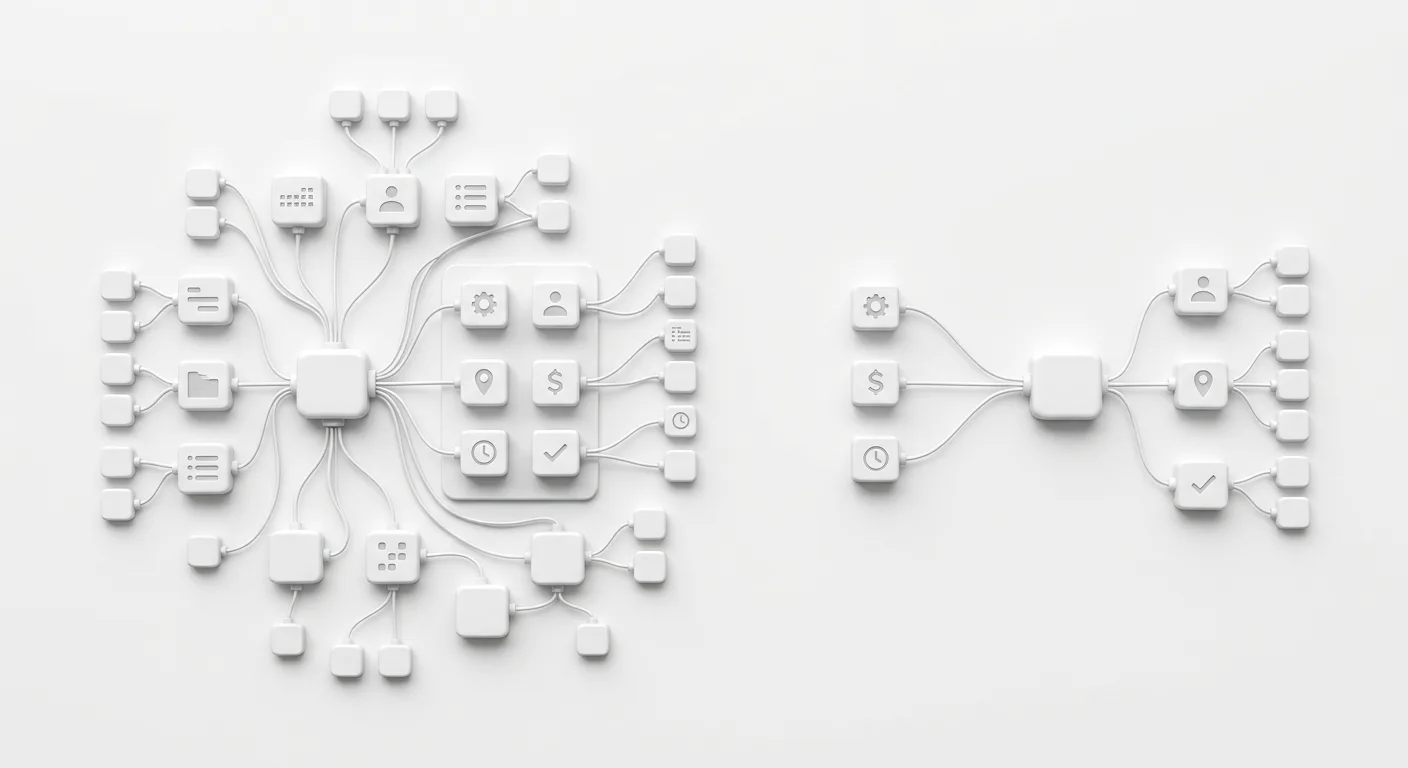
Принцип удаления ключей и значений из JSON-объектов
Формат JSON строится на фундаментальной концепции пар ключ-значение. Каждый элемент данных внутри объекта представляет собой неразрывную связку, где строковый ключ выступает уникальным идентификатором свойства, а значение содержит фактическую информационную нагрузку. Массивы объектов состоят из наборов таких пар, сгруппированных в единые логические блоки.
Суть операции очистки данных, известной в инженерной практике как Data Sanitization, сводится к направленному исключению указанных свойств из исходной структуры. При удалении целевого элемента из объекта вырезается не только сам ключ, но и жестко привязанное к нему значение, независимо от его объема. Если фильтрация применяется к массиву объектов, заданный ключ и соответствующее ему значение последовательно удаляются из каждого элемента массива, где они присутствуют.
Механика исключения затрагивает сразу несколько компонентов внутри конкретного узла:
- Целевой строковый ключ, определяющий удаляемое свойство
- Связанное с ключом значение любого поддерживаемого типа
- Синтаксические элементы, относившиеся исключительно к удаляемой паре
Критическим аспектом такого преобразования является сохранение технической пригодности полученного кода. Исключение конкретных ключей позволяет оставить в файле только необходимые узлы данных, абсолютно не нарушая при этом общую синтаксическую валидность формата JavaScript Object Notation. После извлечения ненужных пар оставшиеся свойства формируют корректную схему, которая полностью соответствует стандартам формата и сразу готова к дальнейшему использованию.
Практические сценарии фильтрации структуры данных
Целенаправленное исключение пар ключей и значений применяется на различных этапах обработки информации. Направленная фильтрация востребована при обмене данными между компонентами системы, подготовке файлов к экспорту и интеграции с внешними сервисами. Выделяют три основных сценария, при которых возникает необходимость модификации исходной схемы.
Подготовка API-ответов
При взаимодействии серверной части с клиентским приложением часто возникает ситуация избыточности выгрузки. Базы данных и внутренние микросервисы генерируют объекты, которые могут содержать специфическую служебную информацию: метки времени создания записей, версии схем, флаги логического удаления или внутренние статусы обработки. Передача таких данных на клиентскую сторону нецелесообразна.
Удаление избыточных системных полей перед отправкой ответа позволяет сформировать чистую структуру. В результате клиент получает только те свойства, которые непосредственно необходимы для работы интерфейса, что упрощает дальнейшую обработку полученного кода на стороне фронтенда.
Очистка от конфиденциальной информации
Экспорт логов, передача сведений аналитическим системам или подготовка дампов для тестирования требуют строгого контроля над содержимым. Исходные массивы объектов часто включают критичные атрибуты, не предназначенные для просмотра сторонними потребителями или системами с пониженным уровнем доступа. Операция исключения по заданному строковому ключу применяется для удаления следующих категорий данных:
- Пользовательские пароли и их криптографические хэши
- Токены авторизации и ключи сессий
- Внутренние идентификаторы инфраструктуры
- Персональные данные пользователей
Исключение указанных ключей из каждого элемента массива гарантирует, что итоговый файл очищен от чувствительной информации и пригоден для дальнейшей передачи без риска компрометации.
Оптимизация полезной нагрузки
Объем передаваемых структур напрямую влияет на потребление пропускной способности сети и время отклика приложения. Присутствие в файле неиспользуемых свойств необоснованно увеличивает физический размер полезной нагрузки (payload). Структурная фильтрация решает задачу уплотнения данных путем удаления узлов, не несущих смысловой или функциональной ценности для принимающей стороны.
В рамках оптимизации целесообразно удалять следующие элементы:
- Поля, содержащие значения null
- Свойства, в которых передаются пустые массивы
- Устаревшие ключи, поддерживаемые исключительно для обратной совместимости
- Избыточные текстовые описания, если требуется только числовая статистика
Извлечение ненужных пар минимизирует количество байтов в конечном документе. Такое преобразование экономит трафик и снижает затраты ресурсов на последующий синтаксический анализ полученной строки принимающим устройством.
Работа с вложенностью: объекты, массивы и иерархия узлов
Формат JSON позволяет выстраивать сложные многоуровневые иерархии, где значениями выступают не только примитивные типы данных, но и другие самостоятельные структуры. При выполнении структурной фильтрации поиск удаляемого свойства требует учета этой архитектуры, поскольку целевой ключ может располагаться на любой глубине дерева узлов.
Логика идентификации целевого поля
Структура документа логически делится на корневой уровень (root) и уровни вложенности. Корневые свойства образуют базовый каркас объекта и находятся на самом верхнем уровне иерархии. Идентификация ключа на корневом этапе происходит путем прямого сканирования основных параметров документа.
Вложенные узлы представляют собой свойства, находящиеся внутри других дочерних объектов или списков. В контексте поиска целевого поля сканирование охватывает все ответвления дерева данных. Если в документе присутствует массив объектов, содержащий набор идентичных элементов, операция исключения применяется к каждому элементу коллекции. Идентификация заданного ключа внутри массива профилей или товарных позиций приведет к удалению этого свойства из каждого отдельного элемента, обеспечивая единообразное преобразование схемы данных для всей коллекции.
Удаление родительских узлов
Иерархическая природа формата диктует строгое структурное правило: удаление родительского ключа автоматически приводит к полному удалению всего вложенного в него содержимого. Базовая единица JSON - связка пары ключ-значение - является неделимой. Если значением целевого свойства выступает другой объект или массив, исключение этого свойства уничтожает весь привязанный к нему блок данных.
Подобная операция напрямую изменяет исходную схему данных и влечет за собой следующие структурные результаты:
- Полное исключение всех дочерних свойств, входивших в состав удаленного родительского объекта
- Ликвидация вложенных массивов вместе со всеми элементами, независимо от их объема и уровня сложности
- Сокращение общей иерархической глубины (вложенности) документа за счет отсечения целой ветви узлов
- Глобальное изменение структуры, требующее от принимающей системы корректной обработки отсутствия ранее ожидавшегося блока информации
Контроль над процессом родительского удаления необходим для точного формирования итоговой полезной нагрузки. Исключение узла высокого порядка выступает эффективным способом быстрой отсечки крупных фрагментов нерелевантной или избыточной информации без необходимости перечислять каждый дочерний ключ по отдельности.
Алгоритм синтаксического анализа и безопасной трансформации
Процесс исключения ключей представляет собой последовательность вычислительных операций, обеспечивающих точное изменение иерархии узлов без повреждения формата. Прежде чем удалить заданное свойство, система должна распознать логические связи между элементами, что требует перевода текстовой информации в программную объектную модель.
Технический цикл преобразования данных состоит из следующих этапов:
- Чтение исходной строки для получения текстового массива входной информации.
- Синтаксический анализ посредством операции JSON.parse для конвертации плоского текста в структурированное дерево объектов и массивов, доступное для программных манипуляций.
- Обход дерева свойств, включающий последовательную навигацию по всем уровням вложенности документа для поиска целевых ключей.
- Фильтрация узлов, в ходе которой происходит исключение найденных ключей и привязанных к ним значений из текущей схемы.
- Обратная сериализация, преобразующая измененную объектную модель обратно в строковый формат.
Определяющей характеристикой архитектуры процесса является клиентская обработка (client-side). Все вычислительные шаги, от первичного парсинга до итоговой сериализации, выполняются локально в оперативной памяти браузера. Исходная структура не передается на внешний сервер и не покидает пределы локального устройства. Такой подход обеспечивает фундаментальную безопасность процесса трансформации, полностью исключая сетевой перехват или сохранение данных на сторонних ресурсах.
Завершение цикла обработки формирует новую синтаксически валидную структуру. Процесс фильтрации аккуратно извлекает запрошенные элементы из дерева свойств, после чего алгоритм сериализации собирает оставшиеся данные в корректный документ, готовый к дальнейшей машинной обработке или интеграции.
Требования к входному коду и валидация результата
Успешное выполнение синтаксического анализа требует строгого соответствия входной строки стандартам формата. Исходный текст должен представлять собой корректный валидный документ, готовый к обработке парсером. Любое структурное отклонение от спецификации приведет к невозможности построения корректного дерева узлов.
К исходному коду предъявляются следующие синтаксические требования:
- Использование двойных кавычек: все строковые ключи и строковые значения должны быть обрамлены исключительно двойными кавычками. Одинарные кавычки или отсутствие кавычек для ключей не допускаются.
- Отсутствие висячих запятых: после последнего элемента в объекте или массиве не должно быть запятой. Это частое нарушение синтаксиса, препятствующее корректному чтению структуры.
- Экранирование спецсимволов: управляющие символы внутри строк, такие как переносы строк, символы табуляции, а также внутренние двойные кавычки, должны быть корректно экранированы с помощью обратного слеша.
После завершения цикла трансформации и обратной сериализации формируется новая строка. Анализ полученного результата сводится к проверке структурной целостности и подтверждению соответствия типов данных.
Интерпретация результата очистки включает следующие аспекты:
- Отсутствие целевых узлов: первичная валидация заключается в подтверждении полного исключения заданных ключей и привязанных к ним значений из иерархии документа.
- Синтаксическая корректность остатка: процесс сериализации обеспечивает сохранение правильного баланса фигурных и квадратных скобок, а также корректную расстановку запятых между оставшимися элементами. Разрывы структуры или пропущенные разделители исключены.
- Неизменность типов данных: все нетронутые поля сохраняют свой первоначальный формат. Строки остаются строками, числовые значения не оборачиваются в кавычки, а логические значения сохраняют свой нативный вид.
Для элементов, не затронутых процессом фильтрации, структура строго выдерживает исходную типизацию, что критически важно для последующей машинной обработки:
| Тип данных | Пример в исходном коде | Состояние в итоговом коде |
|---|---|---|
| Строка | "status": "active" | Без изменений |
| Число | "count": 42 | Без изменений |
| Булево значение | "isValid": true | Без изменений |
Итоговый документ представляет собой точную копию исходной структуры данных за вычетом отфильтрованных узлов. Полученный код полностью готов к интеграции в программные комплексы без необходимости дополнительной валидации типов или ручного исправления синтаксиса.