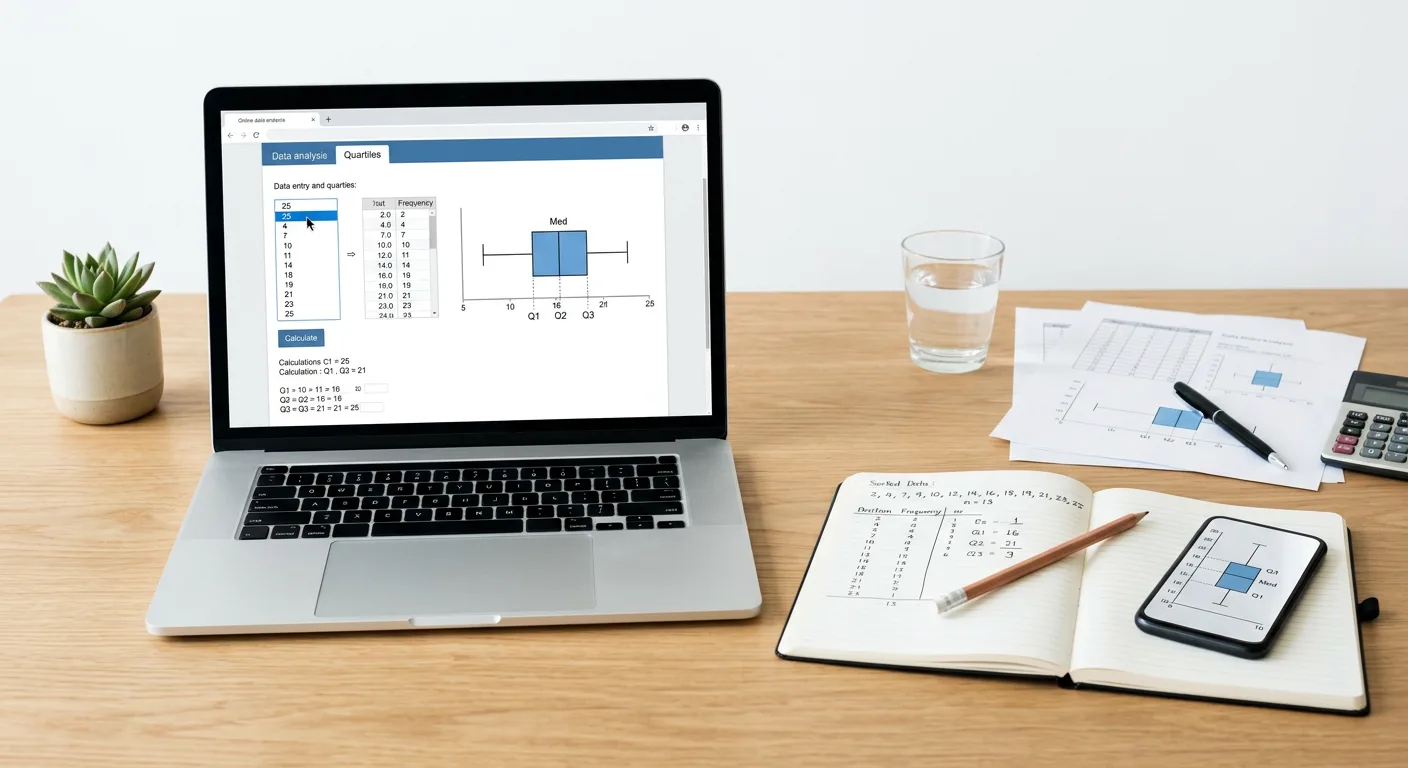
Определение квартильных значений набора данных требуется для оценки мер центральной тенденции и структуры числовых массивов. Инструмент принимает на вход сырой набор чисел. Вычислительный алгоритм преобразует эти данные в отсортированный по возрастанию список. На основе упорядоченной последовательности вычисляются три ключевые точки: нижний квартиль (Q1), медиана (Q2) и верхний квартиль (Q3). Пользователь сразу получает точные значения метрик.
Сформированные точки делят исходную выборку на четыре равные части. Каждый сегмент содержит ровно двадцать пять процентов всех наблюдений. Такое дробление позволяет объективно проанализировать форму распределения. Оно наглядно выявляет асимметрию, оценивает плотность значений вокруг медианы и создает математическую основу для фильтрации аномалий.
Специализированный калькулятор мгновенно структурирует хаотичную выборку. Автоматическая обработка массива исключает смещения при ручной сортировке. Алгоритм корректно работает с любым объемом входящих чисел. Итоговым результатом операции становится готовая сводка значений Q1, Q2 и Q3 для дальнейшего вычисления межквартильного размаха.
Базовые понятия: Квартили в описательной статистике
В анализе данных применяется базовая концепция квантилей. Квантили представляют собой числовые значения, которые разбивают предварительно отсортированный по возрастанию набор данных на заданное количество равных интервалов. Квартили выступают частным и наиболее востребованным случаем квантилей. Они делят упорядоченную выборку или генеральную совокупность ровно на четыре математических сегмента.
В результате разделения образуются четыре группы наблюдений. Каждый отдельный интервал содержит 25 процентов от общего количества элементов исследуемого числового массива. Подобное структурирование позволяет оценить распределение значений по всему диапазону независимо от исходного масштаба чисел.
Формирование четырех сегментов обеспечивается расчетом трех ключевых точек отсечения:
- Первый квартиль (Q1). Метрика называется нижним квартилем и соответствует 25-му перцентилю. Значение отделяет нижние 25 процентов отсортированных данных от остальных 75 процентов элементов массива.
- Второй квартиль (Q2). Показатель представляет собой медиану и эквивалентен 50-му перцентилю. Центральная точка отсечения делит весь набор данных ровно пополам, где одна половина значений меньше или равна метрике, а другая - больше или равна ей.
- Третий квартиль (Q3). Значение определяется как верхний квартиль или 75-й перцентиль. Эта граница отделяет нижние 75 процентов наблюдений от верхних 25 процентов наибольших значений выборки.
Алгоритм и методология расчета квартилей
Процесс вычисления квартилей требует последовательной математической обработки исходного числового массива. Преобразование сырых данных в структурированный набор точек отсечения базируется на строгом алгоритме, состоящем из трех ключевых этапов.
- Прием входного массива числовых данных. На данной стадии неструктурированные элементы собираются в единый рабочий набор, подлежащий последующему анализу.
- Формирование отсортированного списка. Исходный массив перестраивается в строгом порядке возрастания от минимального значения к максимальному. Это обязательное условие, поскольку вычисление любых квантилей опирается на ранжирование элементов выборки.
- Вычисление позиций квартилей. На основе количества элементов в массиве определяются математические индексы, указывающие на конкретные точки разделения внутри упорядоченного ряда.
Базовая методология нахождения конкретных значений опирается на логику последовательного вычисления медианы. На первом шаге вычисляется медиана для всего отсортированного набора данных. Эта центральная точка делит общий массив ровно на две части. После ее нахождения вся выборка сегментируется на нижнюю половину, содержащую элементы до центральной точки, и верхнюю половину со значениями после нее.
Далее алгоритм нахождения медианы применяется к каждой из образованных частей массива по отдельности. Вычисление медианы исключительно для нижней половины набора данных определяет точную позицию первого квартиля. Аналогичный расчет медианы, проведенный только для верхней половины чисел, определяет позицию третьего квартиля.
В процессе вычислений часто возникают ситуации, когда расчетный индекс позиции k-го квартиля не является целым числом. Подобный результат характерен для массивов с определенным количеством наблюдений, где идеальная граница математического разделения попадает в промежуток между двумя соседними элементами отсортированного списка.
Для корректного вычисления значения в таких случаях применяется линейная интерполяция. Если позиция квартиля представляет собой дробное число, итоговый показатель рассчитывается на основе двух фактических элементов массива, окружающих расчетную точку. Формула учитывает разницу между этими двумя числами пропорционально дробной части вычисленного индекса. Использование линейной интерполяции позволяет сформировать точную границу квартиля, даже если итоговое числовое значение физически отсутствует в исходном наборе предоставленных данных.
Сводка пяти чисел и межквартильный размах (IQR)
Вычисленные квартильные значения формируют основу для построения сводки пяти чисел - стандартизированного набора показателей описательной статистики. Этот метод представления информации позволяет получить компактный аналитический срез распределения данных без необходимости изучать каждый отдельный элемент исходного массива.
Структура сводки пяти чисел включает следующие компоненты, расположенные в строгом порядке возрастания:
- Минимальное значение
- Q1
- Q2
- Q3
- Максимальное значение
Наличие этих пяти точек дает исчерпывающее представление о границах выборки и ее центральной тенденции. На базе показателей Q1 и Q3 рассчитывается ключевая мера статистического рассеяния - межквартильный размах. В аналитической практике для обозначения этого показателя применяется аббревиатура IQR.
Математическая формула вычисления межквартильного размаха:
IQR = Q3 - Q1
Полученный результат определяет точную ширину диапазона, внутри которого сосредоточены центральные 50 процентов наблюдений анализируемого набора данных. Данная метрика показывает реальную степень разброса значений вокруг медианы. Чем меньше расчетное значение межквартильного размаха, тем плотнее элементы сгруппированы в центре распределения. Соответственно, широкий межквартильный размах указывает на высокую вариативность средних значений массива.
Главное практическое преимущество IQR заключается в исключительной устойчивости к экстремальным значениям. В отличие от общего размаха выборки, который вычисляется как разница между максимальным и минимальным показателями, межквартильный размах не подвержен искажающему влиянию аномально больших или малых чисел. Поскольку алгоритм расчета учитывает только центральную часть отсортированного списка и математически отсекает верхние и нижние 25 процентов наблюдений, метрика обеспечивает объективную оценку дисперсии основной массы данных, независимо от наличия экстремальных выбросов на концах распределения.
Детекция выбросов на основе квартильного отклонения
Показатель IQR служит математическим базисом для выявления аномалий в анализируемом массиве. Поскольку сам межквартильный размах игнорирует экстремальные значения, он обеспечивает надежный масштаб для определения того, насколько далеко конкретное наблюдение должно отстоять от центральной массы данных, чтобы считаться статистическим выбросом. Стандартный метод детекции опирается на вычисление допустимого интервала с использованием фиксированных коэффициентов масштабирования.
Для установления порогов нормального распределения применяется правило полуторного межквартильного размаха. Алгоритм требует вычисления двух контрольных точек - левой и правой границ, за пределами которых наблюдения признаются статистическими аномалиями.
Формулы расчета контрольных границ:
Левая граница = Q1 - (1.5 × IQR)
Правая граница = Q3 + (1.5 × IQR)
Любой элемент числовой выборки, значение которого оказывается строго меньше расчетной левой границы или строго больше правой границы, изолируется. Коэффициент 1.5 в данном уравнении позволяет охватить естественные колебания данных в стандартных распределениях, отсекая лишь те значения, которые лежат за пределами ожидаемой дисперсии.
В практике обработки данных применяется дополнительная классификация выявленных аномалий по степени их удаленности от центрального диапазона. В зависимости от примененного множителя, выбросы разделяются на две категории:
- Умеренные выбросы: числовые элементы массива, которые выходят за пределы стандартных контрольных границ, рассчитанных с применением базового коэффициента 1.5.
- Экстремальные выбросы: элементы массива, дистанция которых от ближайшего квартиля превышает три межквартильных размаха. Для идентификации таких глубоких аномалий в формулах расчета границ применяется коэффициент 3.0.
Разделение на умеренные и экстремальные выбросы помогает на этапе предварительной очистки набора данных. Умеренные отклонения могут отражать редкие, но реальные события в изучаемой совокупности, тогда как экстремальные значения, преодолевшие порог коэффициента 3.0, чаще всего свидетельствуют об ошибках ввода, аппаратных сбоях или критических искажениях выборки.
Анализ асимметрии и распределения данных
Вычисленные значения квартилей предоставляют базу не только для фильтрации аномалий, но и для оценки общей формы распределения числового массива. Ключевым индикатором здесь выступает взаимное расположение медианы относительно нижней и верхней границ центрального диапазона. Сравнивая расстояние от Q1 до Q2 с расстоянием от Q2 до Q3, можно определить характер скошенности данных без построения сложных частотных графиков.
Для анализа структурной симметрии выборки применяются следующие правила оценки квартильных интервалов:
- Симметричное распределение: разность между Q2 и Q1 равна или максимально близка к разности между Q3 и Q2. В таком массиве значения равномерно распределены относительно центра, а медиана находится ровно посередине межквартильного размаха.
- Положительная асимметрия (правосторонняя скошенность): дистанция от Q2 до Q3 превышает расстояние от Q1 до Q2. Это указывает на то, что верхняя половина центральной части выборки имеет больший разброс значений, а основная концентрация данных смещена в меньшую сторону.
- Отрицательная асимметрия (левосторонняя скошенность): расстояние между Q1 и Q2 больше, чем разница между Q3 и Q2. В этом сценарии нижняя часть центрального диапазона растянута, тогда как основная масса наблюдений сгруппирована в верхней части шкалы.
Рассчитанные математические соотношения и расстояния наглядно визуализируются с помощью специальной диаграммы размаха, известной в анализе данных как Boxplot. Полученные контрольные точки напрямую формируют геометрическую структуру этого графика.
Основной прямоугольник диаграммы строится строго по границам квартилей. Нижний край ящика всегда соответствует значению Q1, а верхний край располагается на уровне Q3. Длина полученного прямоугольника графически отражает величину IQR. Второй квартиль (Q2) обозначается прямой линией, пересекающей внутреннее пространство прямоугольника.
Положение медианной линии внутри ящика является прямым визуальным отражением рассчитанной асимметрии. При строгой симметрии выборки линия делит прямоугольник на две идентичные части. Смещение медианы к нижней границе Q1 визуально подтверждает положительную скошенность. Приближение внутренней линии к верхней границе Q3 указывает на наличие отрицательной асимметрии. Подобная интеграция расчетов со структурой Boxplot позволяет быстро считывать характер распределения, опираясь исключительно на три ключевые координаты массива.
Специфика вычислений: инклюзивный и эксклюзивный методы
При обработке одного и того же числового массива в различных аналитических системах результаты расчета границ могут незначительно расходиться. Подобные расхождения наиболее заметны при анализе малых выборок и практически исчезают по мере увеличения объема данных. Данное поведение не является вычислительной ошибкой. Оно обусловлено применением различных математических алгоритмов для определения точной позиции искомого значения перед этапом линейной интерполяции.
Фундаментальное различие между алгоритмами заключается в отношении к крайним значениям выборки. Существуют два основных подхода к расчету процентилей: инклюзивный и эксклюзивный. Выбор конкретного подхода меняет базу, на которую умножается требуемая доля для нахождения индекса элемента в отсортированном списке.
| Характеристика расчета | Инклюзивный метод | Эксклюзивный метод |
|---|---|---|
| Учет границ диапазона | Включает минимальное (0-й процентиль) и максимальное (100-й процентиль) значения выборки. | Исключает абсолютные границы массива из вычисления позиций процентилей. |
| Формирование базы индекса | Опирается на количество интервалов между значениями. Базовый множитель равен N - 1. | Рассматривает выборку как часть генеральной совокупности. Базовый множитель равен N + 1. |
| Ограничения по объему данных | Метод корректно обрабатывает массивы любого размера, начиная с двух элементов. | Требует достаточного количества наблюдений. Расчет невозможен для очень коротких массивов. |
Понимание применяемого метода критически важно при сверке результатов, полученных в разных программных средах. Различные инструменты анализа данных имеют собственные стандарты по умолчанию и предлагают специфические функции для управления логикой расчета.
- В табличных процессорах, таких как Excel, аналитику предоставляется явный выбор. Функция PERCENTILE.INC вычисляет значения с включением крайних точек массива. Функция PERCENTILE.EXC применяет исключающую логику, что приведет к ошибке вычисления, если массив слишком мал для нахождения требуемой позиции.
- В экосистеме Python библиотека NumPy использует метод numpy.quantile. По умолчанию данная функция применяет линейную интерполяцию, алгоритмически совпадающую с инклюзивным подходом. Метод позволяет передавать дополнительные параметры для изменения математической базы, предоставляя доступ к альтернативным вариантам расчета.
- Базовая функция языка R под названием quantile содержит девять различных типов вычислений. Тип по умолчанию (Type 7) полностью соответствует инклюзивному методу. Это обеспечивает прямую совместимость результатов работы стандартных скриптов R с результатами, полученными в большинстве классических электронных таблиц.
Выбор между методами зависит от природы исходных данных. Инклюзивный алгоритм предпочтителен при анализе замкнутых систем и конечных наборов данных, где минимум и максимум являются строгими пределами. Эксклюзивный алгоритм чаще применяется в инференциальной статистике, когда текущая выборка используется для оценки распределения бесконечной генеральной совокупности, предполагая существование значений за пределами зафиксированного диапазона.