Автоматическое преобразование данных XML в таблицу XLSX решает задачу быстрого извлечения информации из иерархических файлов. Инструмент выполняет прямую онлайн-конвертацию структурированного текста. Вложенные узлы и атрибуты трансформируются в стандартный двумерный массив. Пользователь загружает код разметки и получает готовый табличный документ.
Читать древовидные машинные форматы глазами тяжело. Конвертер мгновенно переводит сложную иерархию в плоскую структуру для привычного визуального анализа.
На вход подается валидный документ XML с единым корневым узлом. Алгоритм последовательно перебирает дочерние элементы, извлекает текстовые значения и распределяет их по столбцам. Результатом операции становится сгенерированный файл XLSX. Строки формируются на основе повторяющихся тегов. Это исключает ручное сопоставление полей через сторонние надстройки и позволяет сразу открыть выгрузку в табличном процессоре.
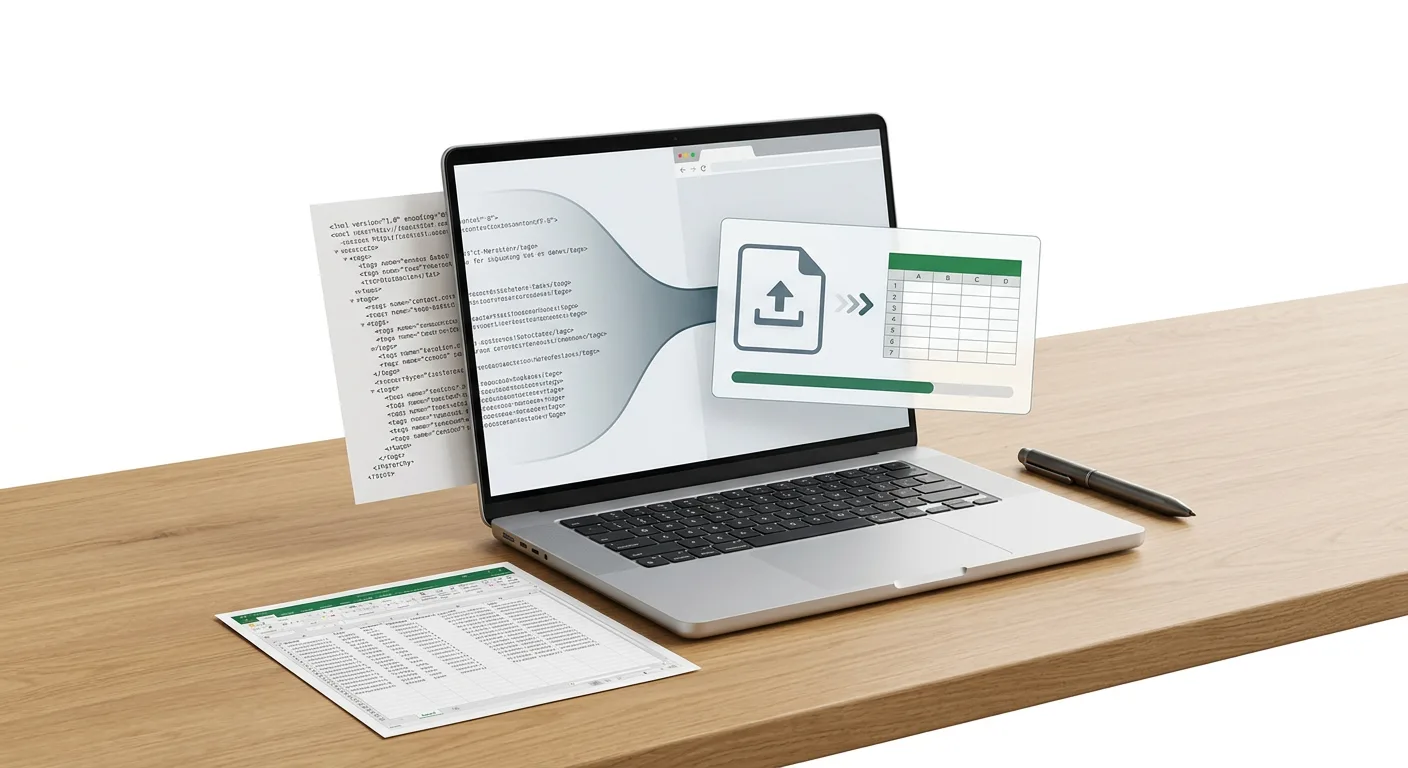
Принцип преобразования иерархии XML в плоскую таблицу
Фундаментальное различие между форматами заключается в способе организации информации. Документ XML представляет собой древовидную модель, состоящую из корневого узла, вложенных элементов и строгой иерархии типа родитель-потомок. Табличный файл XLSX использует двумерную структуру, где данные распределены исключительно по строкам и столбцам. Процесс маппинга данных решает задачу трансформации многоуровневого дерева в плоскую сетку координат.
Различия в архитектуре форматов требуют точного сопоставления элементов при переносе:
| Элемент иерархии XML | Элемент плоской таблицы XLSX |
|---|---|
| Повторяющиеся родительские элементы | Основа для формирования отдельных строк таблицы |
| Названия вложенных тегов | Заголовки столбцов |
| Атрибуты тегов | Дополнительные заголовки столбцов |
| Текстовое содержимое дочерних узлов | Значения в конкретных ячейках листа |
Переход от иерархии к двумерному массиву требует денормализации данных. Логика преобразования строится на разворачивании вложенных уровней. При сканировании исходного документа названия тегов и их атрибуты извлекаются и фиксируются в верхней строке результирующего листа, формируя заголовки столбцов. Каждому уникальному тегу или атрибуту присваивается отдельная колонка. Если в разметке присутствуют глубоко вложенные узлы, их имена сопоставляются таким образом, чтобы структура столбцов отражала принадлежность данных к конкретному родительскому элементу.
Текстовое содержимое дочерних элементов последовательно распределяется по ячейкам листа в соответствии со сформированными заголовками. Повторение однотипного родительского узла инициирует создание новой строки в таблице. Весь массив информации извлекается из тегов и выстраивается в строгий двумерный формат. Атрибуты, которые в исходной разметке служили дополнительными характеристиками узла, конвертируются по тому же принципу и записываются в ячейки наравне с основным текстом дочерних элементов.
Требования к входному XML-документу
Для точного извлечения структурированных данных исходный файл должен строго соответствовать спецификации XML. Обработка массива возможна только при условии, что документ имеет статус корректно сформированного. Фундаментальным требованием синтаксиса является наличие единственного корневого узла, который инкапсулирует все остальные структуры. Размещение нескольких независимых элементов на верхнем уровне разметки исключает возможность построения единого дерева узлов.
Внутренняя иерархия файла выстраивается на основе строгих правил вложенности. Каждый открывающий тег обязан иметь идентичный закрывающий тег. Дочерний элемент должен открываться и закрываться строго внутри своего родительского элемента, перекрестное расположение узлов делает структуру невалидной. Чтение текстового содержимого узлов и значений атрибутов зависит от правильной интерпретации символов. Входной документ может использовать кодировки UTF-8 или windows-1251. Заданная в декларации кодировка обеспечивает безошибочное распознавание кириллических символов и специальных знаков при сканировании разметки.
Архитектура исходного файла напрямую определяет алгоритм работы парсера. На процесс чтения и распределения информации влияют следующие элементы структуры:
- Повторяющиеся родительские элементы. Наличие циклично повторяющихся узлов одного уровня служит для парсера сигналом о начале нового блока связанных данных.
- Атрибуты тегов. Параметры, переданные внутри открывающих тегов, извлекаются из документа как самостоятельные единицы данных, дополняя текстовое содержимое вложенных элементов.
- Пространства имен. Использование Namespaces предотвращает логические конфликты в разметке. При обходе дерева парсер фиксирует префиксы, что позволяет корректно разделять узлы с совпадающими локальными именами, принадлежащие к разным смысловым словарям.
Спецификация выходного файла XLSX
Результатом преобразования структурированной разметки является файл с расширением XLSX, который технически представляет собой стандартный Office Open XML Document. Использование данного формата обеспечивает надежное сохранение извлеченной информации и предоставляет широкие возможности для аналитической обработки данных в двумерной среде.
Внутренняя структура сгенерированного документа строится по строгой матричной схеме, где иерархические связи исходного файла трансформируются в плоскую модель. Распределение данных на листе происходит по следующему алгоритму:
- Формирование строк. Каждая новая строка таблицы создается на основе циклично повторяющихся узлов исходного документа. Один экземпляр повторяющегося родительского элемента образует одну независимую запись в таблице.
- Распределение значений. Текстовое содержимое вложенных элементов и параметры извлеченных атрибутов распределяются по ячейкам соответствующей строки.
- Создание заголовков. Первая строка табличного листа резервируется под названия столбцов. Эти заголовки автоматически формируются из имен тегов и атрибутов, обеспечивая идентификацию данных в колонках.
Полученный файл обладает полной кроссплатформенной совместимостью со всеми современными табличными процессорами. Документ корректно открывается и обрабатывается в таких редакторах, как Microsoft Excel, Google Sheets и LibreOffice Calc. Итоговая таблица представляет собой полностью денормализованный набор данных, готовый к фильтрации, сортировке и вычислениям.
Ключевым преимуществом такого формата выгрузки является отсутствие необходимости в сложной предварительной подготовке рабочего пространства. Пользователю не требуется выполнять ручную настройку карт XML при импорте или выстраивать логику запросов через надстройки уровня Power Query. Вся необходимая информация уже распределена по ячейкам листа и доступна для немедленного использования в бизнес-аналитике и отчетности.
Прикладные сценарии работы со структурированными данными
Быстрое преобразование полуструктурированных массивов в плоскую таблицу востребовано в ситуациях, когда требуется оперативный переход от машиночитаемой разметки к формату, пригодному для бизнес-аналитики и математических расчетов. Денормализация иерархических документов позволяет решать ряд типовых задач по управлению корпоративной и коммерческой информацией.
- Парсинг YML-фидов для Ecommerce. Электронная коммерция регулярно использует стандартизированные товарные фиды, описывающие разветвленное дерево категорий, характеристики позиций, складские статусы и логистические параметры. Перевод формата YML в табличный вид необходим для массового аудита ассортимента, редактирования каталогов и подготовки номенклатуры к загрузке на сторонние маркетплейсы без применения специализированных скриптов-парсеров.
- Конвертация выгрузок баз данных. Экспорт целых таблиц или результатов сложных запросов из СУБД часто осуществляется в виде файлов с теговой структурой для обеспечения переносимости. При необходимости ручной верификации дампа, поиска дубликатов или построения аналитических дашбордов вне среды базы данных, промежуточная трансформация в XLSX открывает прямой доступ к привычным инструментам сортировки и сводным таблицам.
- Обработка складских ведомостей и прайс-листов. Обмен спецификациями и товарными остатками между контрагентами базируется на согласованных схемах обмена данными. Представление этих документов в виде двумерной сетки требуется для проведения сверок, сравнения закупочных цен, расчета маржинальности и связывания полученной информации с внутренними учетными реестрами.
- Интеграция выгрузок из систем ЭДО. Платформы ЭДО генерируют накладные, акты и формализованную отчетность в виде строго структурированных файлов, где числовые показатели скрыты глубоко в иерархии узлов. Финансовым контролерам и бухгалтерам необходимо извлекать транзакционные записи, суммы налогов и реквизиты из таких документов для консолидации реестров первичной документации и проверки финансовых моделей.
Во всех приведенных примерах основной целью является отделение чистых данных от служебного синтаксиса разметки. Полученная в результате табличная структура ликвидирует вложенность элементов, позволяя специалистам сразу приступить к обработке извлеченных числовых и текстовых значений стандартными средствами табличных процессоров.
Алгоритм выполнения конвертации
Процедура трансформации иерархического документа в табличный формат представляет собой последовательность действий, направленную на извлечение значений и их распределение по сетке документа. Переход от теговой разметки к плоской таблице не требует написания скриптов или предварительного проектирования реляционной схемы.
Цикл преобразования структурированных данных состоит из следующих этапов:
- Передача исходных данных. На данном этапе осуществляется загрузка файла формата .xml, содержащего необходимую для извлечения информацию.
- Инициация процесса парсинга и преобразования типов данных. Движок конвертации анализирует текстовое содержимое загруженного документа, обходит дерево узлов и адаптирует извлеченные значения под форматы ячеек табличного редактора.
- Получение результата. Завершение обработки сопровождается генерацией готового файла с расширением .xlsx, который становится доступным для скачивания.
Ключевой характеристикой описанного процесса является автоматическое сопоставление элементов. Формирование заголовков столбцов и заполнение строк происходит на основе синтаксического анализа исходного файла без ручного вмешательства в структуру данных. Это позволяет конвертировать документы с неизвестной или часто меняющейся вложенностью, исключая необходимость каждый раз обновлять правила импорта.