Преобразование данных JSON в формат CSV решает техническую задачу перевода машиночитаемых иерархий в плоские таблицы. Инструмент выполняет парсинг исходных структурированных данных типа application/json. На выходе генерируется классический двумерный массив text/csv.
JSON часто передает информацию в виде многоуровневого дерева со сложной вложенностью. Алгоритм конвертации требует обязательного выпрямления таких иерархических структур. Каждая ветвь должна быть программно извлечена и переведена в плоский формат строк и столбцов. Без предварительного уплощения вложенных узлов прямой экспорт исходного кода в реляционные базы данных или табличные процессоры математически невозможен из-за разницы парадигм хранения.
Итогом вычислений становится нормализованный текстовый набор. Файл готов к моментальному импорту в аналитические системы.
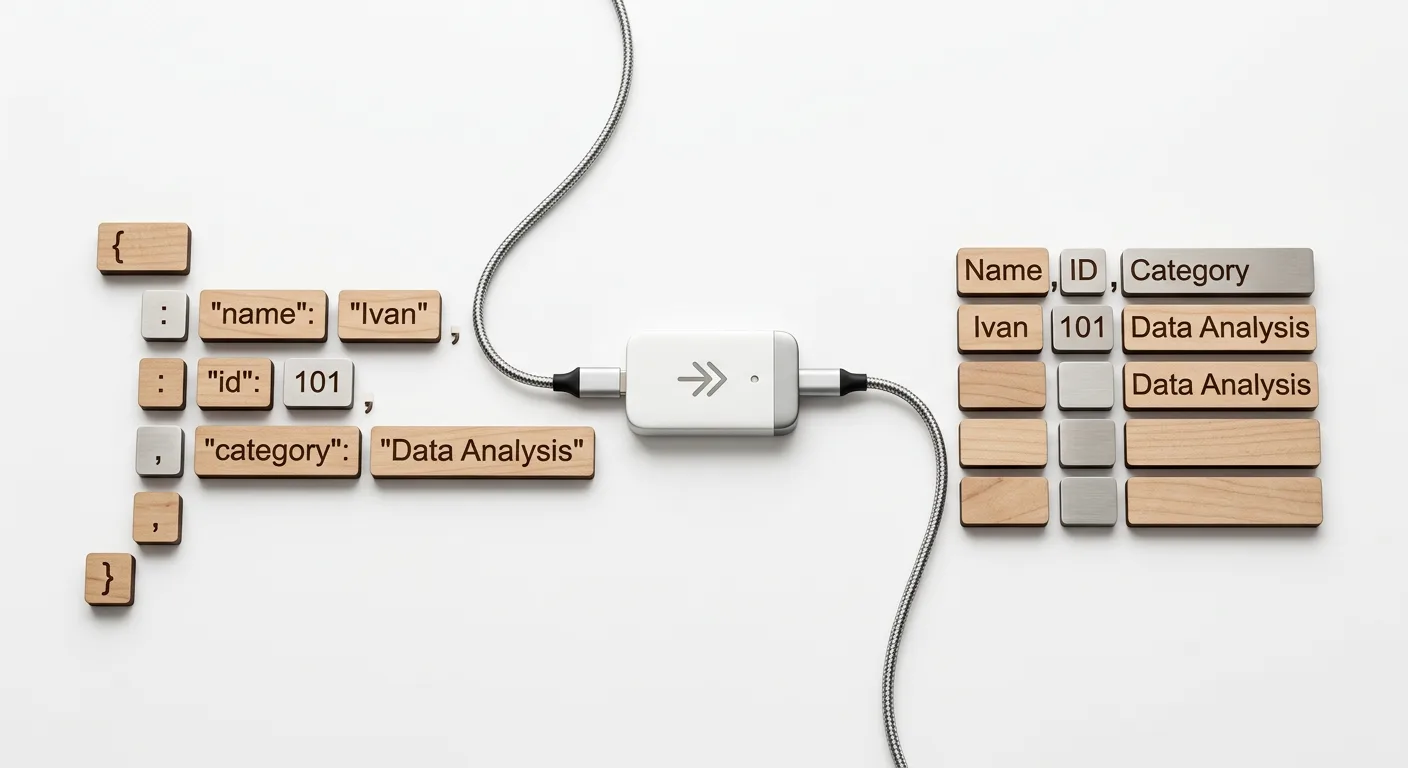
Различия структур данных: иерархия JSON и плоская таблица CSV
Главное различие между форматами заключается в их архитектурной парадигме. Переход от одного формата к другому требует изменения самой топологии данных: от многомерной графовой модели к жесткой сеточной структуре.
Формат JSON поддерживает иерархическую организацию информации. Данные формируются через пары ключ-значение и могут иметь неограниченную глубину вложенности. Эта архитектура позволяет конструировать сложные древовидные структуры, включающие вложенные объекты и массивы массивов. В типе данных application/json один родительский элемент может содержать множество дочерних узлов с различными типами данных, что делает формат гибким, но сложным для линейного парсинга.
Формат CSV представляет собой строгую двумерную модель для хранения плоских табличных данных. Вся информация в text/csv организована в виде сетки, состоящей из строк и столбцов. В этой парадигме полностью отсутствует понятие вложенности или иерархии - каждая запись представляет собой самостоятельную плоскую текстовую строку, где значения ячеек следуют друг за другом.
Архитектурные парадигмы форматов имеют строгие концептуальные различия в способе хранения информации.
| Характеристика | JSON | CSV |
|---|---|---|
| Топология данных | Иерархическая (древовидная) | Плоская (табличная) |
| Мерность | Многомерная | Двумерная |
| Базовые элементы | Вложенные объекты, пары ключ-значение | Строки, столбцы, ячейки |
| Вложенность структур | Поддерживается (массивы массивов) | Отсутствует |
Математическая и логическая причина преобразования заключается в фундаментальной несовместимости многомерных иерархий с реляционными моделями данных. Реляционные базы данных оперируют строгими двумерными массивами. Чтобы загрузить сложную структуру application/json в такую систему, необходимо спроецировать многомерное дерево на двумерную плоскость. Это требует приведения всех ветвей к плоскому виду text/csv, где каждый уникальный путь в иерархии трансформируется в столбцы и строки для обеспечения совместимости с табличной логикой.
Логика преобразования: выпрямление вложенных объектов и массивов
Процесс нормализации при переходе от иерархии к таблице опирается на алгоритм уплощения (flattening). Операция Data transformation необходима для разворачивания многомерных путей в линейную последовательность. Когда исходная структура представляет собой массивы объектов (array of objects), логика обработки разделяет массив таким образом, чтобы каждый корневой объект сформировал самостоятельную строку в финальной таблице.
Обработка сложных вложенных структур данных (Nested Data) требует линейного объединения ключей. Если внутри основного объекта содержится другой объект, путь к конечному значению выстраивается путем конкатенации родительского и дочернего уровней. Ветвящееся дерево проецируется в горизонтальную плоскость, где глубина иерархии трансформируется в составные названия столбцов, позволяя сохранить логическую связь данных без использования многомерности.
Принцип сопоставления столбцов
Геометрия плоской сетки требует строгого выравнивания колонок для всех записей. Формирование структуры начинается с полного сканирования пар name/value pairs. Из объектов извлекаются все существующие ключи, после чего уникальные значения агрегируются для генерации первой строки заголовков.
В случае обработки асимметричных данных, где объекты содержат разный набор ключей, применяется принцип дополнения пустот. Если в текущем объекте отсутствует ключ, заявленный в строке заголовков, при сопоставлении столбцов в этой позиции формируется пустая запись. Это предотвращает смещение данных и гарантирует, что значения всегда соответствуют своим колонкам.
Сериализация базовых типов данных
Целевой формат оперирует исключительно простыми текстовыми записями без метаданных о типах. В связи с этим преобразование включает процесс сериализации, приводящий все исходные значения к плоскому текстовому виду. Правила обработки зависят от исходного типа данных:
- Строковые значения транслируются в ячейки таблицы как обычный текст.
- Числовые значения, включая целые числа и значения с плавающей точкой, переносятся в виде текстовых символов, сохраняя математическую точность записи.
- Булевы значения сериализуются в соответствующие текстовые литералы true и false.
- Нулевые записи, обозначенные как null, интерпретируются как полное отсутствие данных и конвертируются в пустые ячейки таблицы.
Спецификация формирования CSV-файла: разделители и экранирование
Результат преобразования сериализованных данных формируется в строгом соответствии со стандартом RFC 4180. Данная спецификация регламентирует синтаксис текстового файла, обеспечивая его корректную интерпретацию парсерами. Процесс генерации начинается с записи строки заголовков (CSV header row). Эта стартовая строка содержит извлеченные уникальные ключи и служит шаблоном для распределения значений во всех последующих строках документа.
Архитектура плоского формата базируется на использовании служебных символов-разделителей. На горизонтальном уровне значения ячеек отделяются друг от друга запятой. На вертикальном уровне граница между отдельными объектами данных обозначается последовательностью переноса строки CRLF. Такое разделение создает двумерную сетку исключительно средствами обычного текста.
Правила экранирования текстовых значений
Поскольку исходные строковые значения могут содержать символы, совпадающие с системными разделителями формата, применяется алгоритм изоляции данных. Для сохранения целостности структуры используется экранирование с помощью двойных кавычек. Процедура изоляции гарантирует, что внутреннее содержимое ячейки будет обработано как единый текстовый блок, а не как управляющие команды. Экранирование применяется в следующих ситуациях:
- Наличие внутренних разделителей: если строковое значение содержит запятую, вся запись автоматически оборачивается в двойные кавычки.
- Наличие переносов строк: присутствие символов CRLF внутри самого значения требует обязательной изоляции кавычками для предотвращения структурного разрыва строки таблицы.
- Наличие кавычек в тексте: если исходный текст включает двойные кавычки, применяется правило удвоения. Каждая внутренняя кавычка дублируется, после чего вся конструкция дополнительно заключается в обрамляющие двойные кавычки.
Символьная кодировка UTF-8
Для сохранения семантической и визуальной точности текстовых данных при формировании файла применяется кодировка UTF-8. Использование этого стандарта обеспечивает корректный экспорт всего спектра Unicode-данных. Кодировка UTF-8 гарантирует, что многоязычные символы, математические операторы и специфические текстовые знаки, присутствовавшие в исходной иерархии, будут записаны в плоский файл без искажений и потери информации.
Практическое применение табличных данных из API-ответов
Преобразование иерархических структур в двумерный формат востребовано при обработке выгрузок из веб-сервисов и нереляционных хранилищ. Типовая аналитическая задача заключается в экспорте структурированной полезной нагрузки, такой как системные API-ответы, логи транзакций или массивы документов из NoSQL баз. Изначальный формат оптимизирован для межсерверного обмена, поэтому для последующего анализа данных требуется его приведение к плоскому виду.
Полученный результат представляет собой отформатированный текстовый файл, готовый к прямому импорту в классические электронные таблицы, включая MS Excel и Google Таблицы, а также в системы управления реляционными базами данных. В процессе импорта текстовые значения и числа распределяются по ячейкам на основе сформированной строки заголовков, создавая стандартную рабочую сетку.
Наличие информации в виде плоского формата исключает необходимость написания программных скриптов для парсинга исходных многомерных массивов. Использование табличного представления позволяет специалистам сразу переходить к обработке информации с помощью встроенного инструментария табличных процессоров:
- Построение сводных таблиц для агрегации показателей, быстрого суммирования и группировки данных по выбранным измерениям.
- Применение статистических, математических и логических табличных функций к целым столбцам или отдельным числовым диапазонам.
- Многоуровневая фильтрация и сортировка записей по заданным текстовым, числовым или временным критериям.
- Связывание текущего набора данных с другими корпоративными таблицами через уникальные идентификаторы и функции поиска.
Экспорт серверной выдачи в табличный вид обеспечивает непрерывность рабочего процесса. Двумерный формат выступает универсальным мостом между технической инфраструктурой, генерирующей данные, и аналитическими системами, предназначенными для их расчетов и визуализации.