Преобразование данных CSV в формат YAML решает задачу перевода плоских табличных массивов в машиночитаемый иерархический вид. Инструмент выполняет точную сериализацию текстовой информации. На входе система принимает набор данных с разделителями, а на выходе генерирует структурированный конфигурационный код.
Базовый принцип конвертации строго подчинен геометрии исходной таблицы. Заголовки столбцов CSV выступают в роли ключей. Строки трансформируются в элементы последовательности. В результате формируется массив независимых объектов, где каждое значение ячейки автоматически привязывается к соответствующему параметру из первой строки файла.
Такой алгоритм исключает ручной перенос параметров при подготовке конфигурационных файлов.
Практическое применение полученного кода напрямую связано с автоматизацией инфраструктуры. Сгенерированные иерархические структуры готовы к прямой интеграции в процессы развертывания, управления программными средами и настройки серверного окружения.
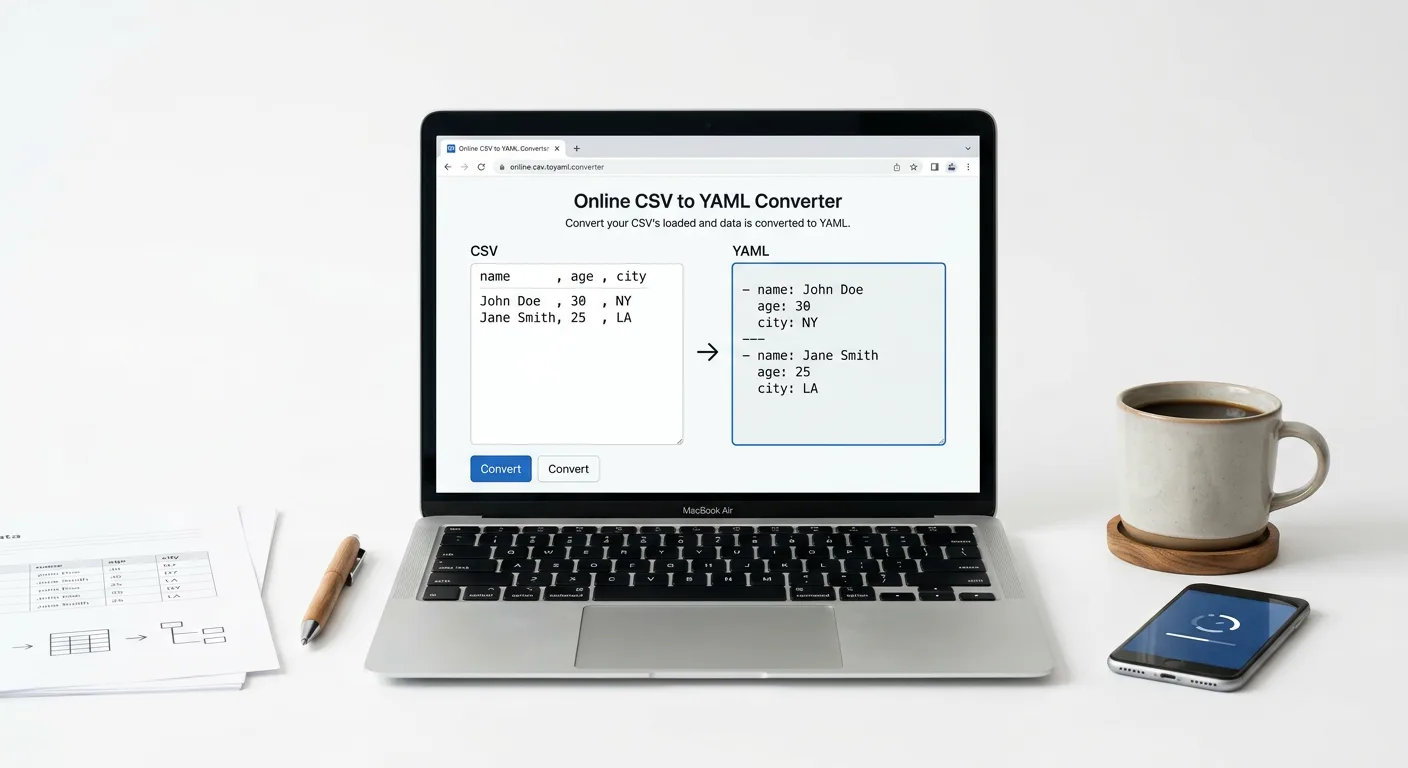
Архитектура данных: от плоской таблицы CSV к иерархии YAML
Логика конвертации строится на кардинальном различии в архитектуре двух форматов. Преобразование требует перехода от плоской табличной модели к иерархической структуре, основанной на пространственной вложенности.
Формат CSV представляет собой простой текстовый файл стандарта plain text. Архитектура таких данных базируется на концепции двумерного массива. Информация организована строго в виде строк, где каждое значение отделено от соседнего специальным символом-разделителем. Подобная геометрия оптимальна для транзита реляционных баз данных и выгрузок из электронных таблиц, однако она не имеет встроенных синтаксических механизмов для описания многоуровневых зависимостей.
Формат YAML выступает стандартом сериализации данных. В отличие от табличной сетки, его архитектура не привязана к жестким колонкам. Иерархия выстраивается за счет отступов, а базовой единицей хранения информации является структура ключ-значение. Это позволяет создавать глубокие деревья объектов, списки и сложные ассоциативные связи в удобочитаемом текстовом виде.
Сравнение архитектурных особенностей форматов демонстрирует разницу в подходах к компоновке информации:
| Характеристика | CSV | YAML |
|---|---|---|
| Тип структуры | Двумерный массив | Иерархическое дерево объектов |
| Способ организации | Строки и разделители текста | Отступы и блоки сериализации |
| Базовый элемент | Пересечение столбца и строки | Пара ключ-значение |
Математическая и логическая модель преобразования заключается в пространственной трансформации двумерной сетки в список независимых объектов. Вместо сохранения привязки к номерам столбцов, данные перестраиваются вокруг смысловых параметров.
Логика изменения архитектуры данных разбивается на следующие структурные шаги:
- Чтение плоского текстового массива и его сегментация на горизонтальные векторы.
- Трансформация каждой отдельной строки исходной таблицы в изолированный ассоциативный массив.
- Сборка всех сгенерированных словарей в единый родительский список YAML.
Переход между форматами полностью устраняет изначальную концепцию неименованных ячеек. Табличная запись становится самодостаточным элементом последовательности, где структура ассоциативного массива гарантирует сохранность связей внутри каждого объекта.
Структурирование и парсинг входных данных CSV
Процесс конвертации опирается на строгую табличную геометрию входного файла. Критическим элементом этой структуры выступает строка заголовка. Первая строка массива выполняет роль схемы данных, определяя набор ключей для всех генерируемых сопоставлений YAML. Значение каждой ячейки из первой строки извлекается и фиксируется в качестве постоянного идентификатора столбца. При трансформации последующих строк таблицы эти идентификаторы становятся ключами, к которым привязываются значения соответствующих ячеек.
Корректное извлечение данных зависит от точного определения границ ячеек. Разделитель указывает точку сечения плоского текста на отдельные элементы. На практике применяются три основных варианта сегментации столбцов:
- Запятая выступает базовым разделителем для классического стандарта CSV.
- Точка с запятой применяется для предотвращения конфликтов в региональных форматах, где обычная запятая служит десятичным знаком в числовых значениях.
- Символ табуляции используется при обработке выгрузок из систем управления базами данных и табличных процессоров.
Сложности при парсинге возникают, когда текстовое содержимое отдельной ячейки включает символы, совпадающие с активным разделителем, или содержит переносы строк. Для сохранения целостности таких полей применяются правила квотирования и экранирования.
Символ кавычек изолирует проблемный фрагмент текста. Алгоритм считывает все символы внутри парных двойных кавычек как единый блок данных. Любые разделители, находящиеся внутри этой конструкции, воспринимаются как часть обычного текста и не приводят к разбиению строки на новые столбцы.
| Исходная запись CSV | Принцип чтения ячейки |
|---|---|
| node_01,running,eu-west | Стандартное чтение от разделителя до разделителя. |
| node_02,running",Paris, France" | Символ кавычек отменяет структурное действие запятой внутри текста локации. |
Дополнительным механизмом обработки сложных строковых значений выступает экранирование символов. Обратный слеш, помещенный перед служебным знаком или внутренней кавычкой, меняет логику интерпретации текста. Экранированный знак читается исключительно как часть строкового значения, что предотвращает преждевременное завершение чтения ячейки парсером и исключает сдвиг столбцов в итоговом ассоциативном массиве.
Синтаксис и форматирование результирующего YAML
Завершение чтения разделителей и текстовых блоков инициирует процесс сборки иерархического документа. Исходная табличная структура преобразуется в последовательность, состоящую из ассоциативных массивов. Для визуального и структурного представления генерируемых данных применяется стандартный блочный стиль.
Маркером начала нового элемента в последовательности выступает символ дефиса. Каждая строка обрабатываемой таблицы генерирует отдельный объект под таким маркером. За дефисом следует обязательный пробел, отделяющий служебный символ от фактического содержимого узла.
Внутри каждого сформированного блока генерируются пары "ключ: значение". Синтаксис спецификации требует точного позиционирования пунктуации при их записи. Двоеточие выступает границей между идентификатором поля и его содержимым. Наличие пробела после двоеточия является критическим условием для валидности документа. Отсутствие этого пробела приводит к фатальной ошибке чтения, так как принимающий парсер классифицирует всю конструкцию как единую строку, а не как пару.
Правила формирования отступов
Логическая вложенность элементов и принадлежность параметров конкретному объекту задается исключительно отступами. Фундаментальное правило сериализации в формат YAML обязывает использовать для создания иерархии только пробелы. Символы табуляции строго запрещены спецификацией формата для выравнивания структуры.
Запрет на использование табуляции внедрен для предотвращения ошибок интерпретации конфигурационных файлов в различных операционных системах и средах разработки, где визуальная длина табуляции может варьироваться. Генерация отступов с помощью пробелов гарантирует идентичное чтение документа любым программным обеспечением.
- Базовый уровень последовательности фиксируется выравниванием дефисов по одному вертикальному краю.
- Внутренние параметры объекта смещаются вправо относительно начала документа для закрепления иерархической зависимости.
- Выравнивание всех пар параметров внутри одного логического блока должно быть строго идентичным.
Схема генерации выходного кода
Взаимодействие синтаксических конструкций при финальной сборке документа подчиняется строгому порядку форматирования.
| Синтаксический элемент YAML | Назначение в результирующем документе |
|---|---|
| - (Дефис с пробелом) | Инициализация нового объекта в общей последовательности записей. |
| : (Двоеточие с пробелом) | Разделение ключа и соответствующего ему значения внутри текущего объекта. |
| Пробелы (Indentation) | Создание блоков данных и фиксация вложенности параметров под конкретным дефисом. |
Соблюдение блочного стиля вывода позволяет визуально отделить записи друг от друга. Технически каждый объект под дефисом становится самостоятельным словарем, независимым от соседних элементов последовательности, но подчиняющимся общим правилам отступов всего документа.
Обработка типов данных при сериализации
Исходный формат CSV представляет собой нетипизированный текст, где абсолютно все значения выступают обычными последовательностями символов. При сериализации в YAML возникает задача корректной интерпретации этих текстовых данных для сохранения их семантики. Целевой формат поддерживает нативные типы данных, поэтому процесс конвертации включает логическое приведение строковых значений из ячеек таблицы к числам, логическим переменным или правильно отформатированным строкам.
Интерпретация примитивных значений
Распознавание базовых типов происходит на основе лексического анализа содержимого каждого поля. Если парсер может однозначно классифицировать значение как нечто иное, чем просто текст, оно записывается в итоговую структуру без строковых ограничителей.
| Тип данных | Критерии распознавания текста CSV | Правило вывода в YAML |
|---|---|---|
| Целые числа (Integer) | Последовательность состоит исключительно из цифр, возможно наличие знака минуса в начале. | Выводится как числовое значение без кавычек. |
| Числа с плавающей точкой (Float) | Наличие цифр и одного допустимого разделителя дробной части (обычно точки). | Выводится как числовое значение без кавычек. |
| Логические значения (Boolean) |
Точное совпадение текста со словами
true
или
false
.
|
Выводится как нативный булев тип без кавычек. |
Сохранение числовых и логических типов в чистом виде критически важно для последующей машинной обработки конфигурационных файлов, где значение
42
(число) и
"42"
(строка) приводят к разному поведению систем.
Форматирование и экранирование строк
Большая часть текстовой информации переносится в результирующий файл без дополнительных модификаций. Однако синтаксис целевого языка накладывает строгие ограничения на использование зарезервированных символов внутри неквотированных строк. Присутствие определенных знаков требует обязательного добавления кавычек (одинарных или двойных) вокруг всего значения.
Квотирование применяется автоматически, если исходная строка из таблицы содержит следующие элементы:
-
Двоеточие с последующим пробелом
:, которое может быть ошибочно воспринято парсерами как разделитель новой пары ключ-значение. -
Начинающийся с дефиса
-текст, имитирующий инициализацию нового элемента массива. -
Квадратные
[,]или фигурные{,}скобки, которые зарезервированы для создания inline-списков и словарей. -
Текстовые значения, полностью совпадающие с зарезервированными ключевыми словами, такими как
null,trueилиfalse, если их необходимо передать именно как строку.
Добавление кавычек гарантирует, что любой сложный текст, включая пути к файлам, URL-адреса с параметрами или технические описания, будет прочитан целевым приложением исключительно как единое строковое значение, не ломая общую структуру документа.
Логика обработки пустых строк
В исходном табличном массиве часто встречаются пустые строки, возникающие из-за особенностей экспорта данных из редакторов или наличия лишних переносов каретки в конце файла. Обработка таких аномалий сводится к их полному игнорированию на этапе парсинга.
Пропуск пустых строк предотвращает генерацию неполноценных объектов в финальной последовательности. Если бы пустая строка обрабатывалась как валидная запись, это привело бы к появлению в выходном коде висячих дефисов или ключей со значениями
null
, что нарушает целостность иерархической структуры и может вызвать ошибки при чтении сериализованных данных сторонними анализаторами.
Практические сценарии применения сгенерированного YAML
Полученный в результате трансформации иерархический код служит готовым источником данных для систем управления конфигурациями, оркестраторов и процессов непрерывной интеграции. Табличное представление удобно для массового заполнения параметров, тогда как сериализованный формат необходим для машинной обработки.
Управление инфраструктурой и развёртыванием
Поддержка матрицы серверов, микросервисов или сетевых правил часто ведётся в плоских таблицах. Преобразование этих массивов в YAML решает задачи автоматизации при администрировании инфраструктуры:
- Манифесты Kubernetes и Docker Compose: Исходная таблица может содержать перечень микросервисов, где столбцы определяют имена образов, открываемые порты, переменные окружения и лимиты ресурсов. Сгенерированный массив объектов напрямую переносится в манифесты развёртывания для массового запуска контейнеров.
- Плейбуки Ansible: Списки инвентаризации целевых машин, наборы ролей или специфичные параметры окружений выгружаются из баз данных в CSV. Итоговый YAML используется для описания переменных, которые Ansible применяет при автоматизированной настройке узлов.
- Генерация конфигурационных списков: Массивы с системными лимитами, правилами маршрутизации, конфигурациями баз данных или доступами пользователей конвертируются в статические файлы настроек, которые считываются целевыми приложениями на этапе инициализации.
Организация процессов локализации (i18n)
Рабочие процессы интернационализации программного обеспечения традиционно опираются на табличные редакторы, поскольку это наиболее эффективная среда для работы переводчиков. Стандартная структура таких файлов включает столбец с техническим идентификатором строки и смежные столбцы с переводами для каждого поддерживаемого языка.
При выгрузке таблицы переводов в CSV и её конвертации формируются структурированные YAML-словари. Интеграция этой процедуры в CI/CD-конвейеры позволяет выстроить процесс автоматического обновления языковых пакетов. На этапе сборки проекта свежие переводы преобразуются в машиночитаемые словари и встраиваются в приложение, полностью исключая ручной перенос текстов из таблиц в программный код.