Структурирование документа XML необходимо для преобразования сплошного массива неформатированного кода в читаемый древовидный вид. Процесс форматирования возвращает визуальную логику вложенным элементам. Исходные данные часто представляют собой непрерывную строку текста без пробелов и абзацев, которую выдают автоматизированные серверные системы или API. Работать с таким машинным форматом вручную крайне сложно. Инструмент парсит исходный текст, анализирует синтаксис и выстраивает иерархию элементов.
Базовая механика операций Beautify и Prettify заключается в алгоритмическом расчете отступов и добавлении переносов строк после закрывающих тегов. В результате родительские и дочерние элементы получают визуальные границы, а атрибуты и текстовое содержимое нод выстраиваются в строгую систему. Разметка приобретает пространственный объем.
Визуальное разделение уровней вложенности обеспечивает удобный просмотр и анализ структуры документа человеком. Без форматирования поиск нужного узла данных превращается в слепой перебор символов. Структурированное представление мгновенно раскрывает архитектуру файла. Пользователь сразу видит логическую карту данных вместо нечитаемого монолитного блока текста.
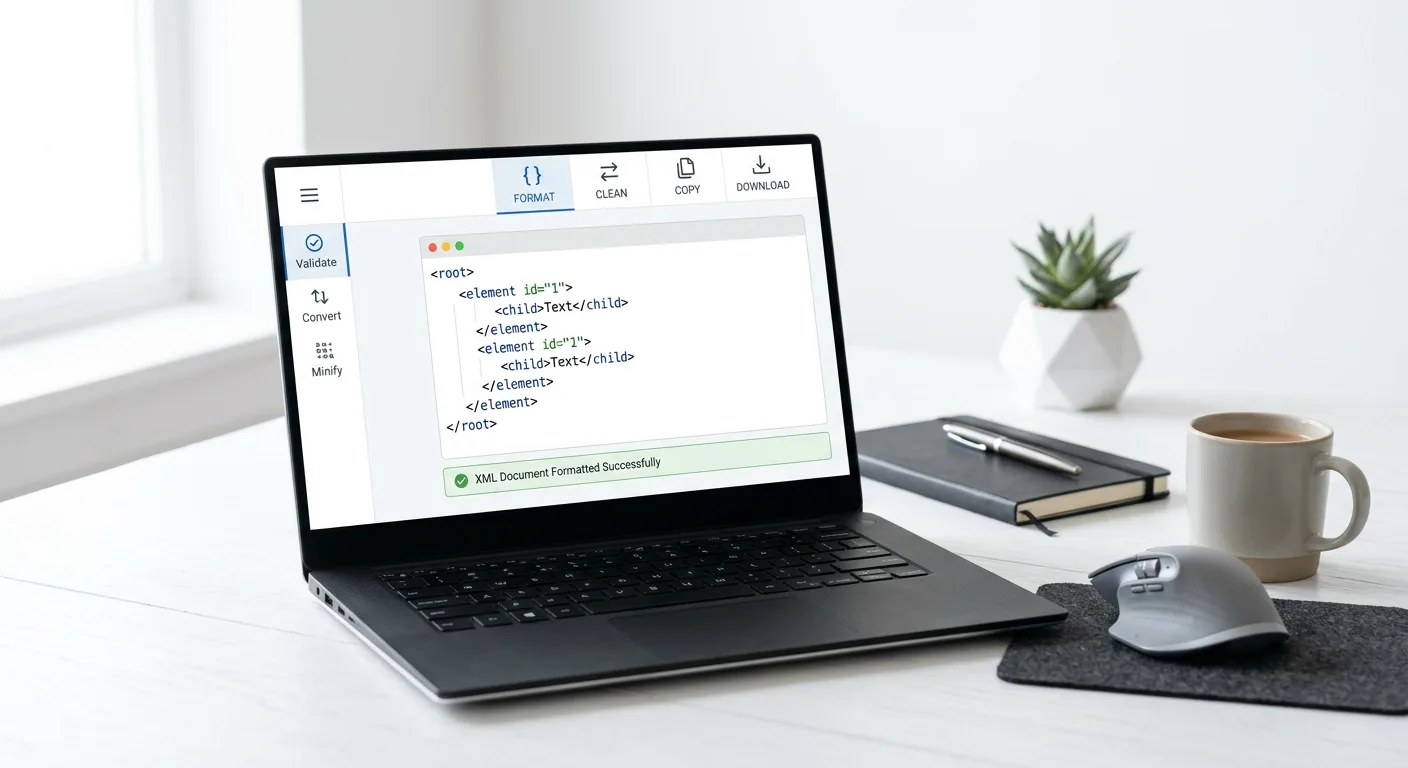
Иерархическая древовидная структура XML
Архитектура документа XML базируется на строгой иерархической модели, представляющей собой логическое дерево. Каждый компонент данных занимает строго определенное место в этой системе координат, подчиняясь правилам вложенности. Фундаментом структуры выступает корневой элемент. Он является единственным узлом верхнего уровня, который инкапсулирует все остальные данные в файле. Любой синтаксически корректный документ содержит ровно один корневой элемент.
Внутри корневого элемента располагаются дочерние узлы. Они формируют последующие уровни вложенности. Каждый дочерний элемент может выступать родительским узлом для других элементов, создавая многоуровневую структуру любой необходимой глубины. Позиция каждого узла определяет его логическую связь с остальными частями документа и формирует общую топологию данных.
Синтаксис разметки и компоненты узлов
Иерархия выстраивается с помощью системы тегов, которые обозначают точные границы каждого узла. Стандартный элемент состоит из трех основных частей:
- Открывающий тег задает начало узла и содержит его имя, заключенное в угловые скобки.
- Текстовое значение представляет собой полезные данные, расположенные внутри узла.
- Закрывающий тег обозначает конец узла и включает символ косой черты перед именем.
Элементы, не содержащие текстовых значений или других дочерних узлов, используют синтаксис самозакрывающихся тегов. В этом формате символ косой черты ставится в конце единственного тега, объединяя функции открытия и закрытия элемента в одной конструкции.
Внутри открывающего тега могут располагаться атрибуты. Они предоставляют метаданные об элементе и всегда оформляются в виде пар имя-значение. Значение атрибута обязательно заключается в прямые кавычки. Атрибуты не могут содержать внутри себя другие узлы или формировать дополнительные уровни вложенности дерева, они строго привязаны к конкретному тегу.
Служебные секции документа
Помимо основного дерева элементов, формат включает специализированные блоки данных, определяющие правила обработки файла парсером.
- Prolog располагается в самом начале файла до корневого элемента. Он содержит XML декларацию, указывающую версию стандарта, и определяет кодировку символов документа.
- Секции CDATA используются для размещения неформатированных символьных данных. Текст внутри таких секций игнорируется при синтаксическом анализе разметки, что позволяет безопасно хранить фрагменты кода или служебные символы без риска нарушения структуры дерева.
Технический стандарт формата не регламентирует обязательное использование пробелов или переносов строк между узлами. Машинные системы часто генерируют сплошной текст, размещая корневой элемент, сотни дочерних узлов, атрибуты и служебные секции в единую непрерывную строку. В таком виде визуальные границы между уровнями вложенности полностью стираются. Человеку становится крайне сложно визуально сопоставить открывающие и закрывающие теги, определить глубину узла и принадлежность текстовых значений. Отсутствие пространственного разделения превращает структурированную иерархию данных в монолитный массив символов, скрывающий фактическую архитектуру документа.
Принцип алгоритмического форматирования разметки
Для преобразования монолитного текстового массива в читаемую структуру исходный код проходит стадию синтаксического анализа. Парсер считывает непрерывную строку и выстраивает DOM. На этом этапе определяются точные иерархические связи: выявляются уровни вложенности, отделяются теги от текстового содержимого и фиксируются служебные конструкции. После построения математической модели дерева запускается алгоритм визуального форматирования, который опирается на вычисленную глубину каждого отдельного узла.
Механика распределения отступов и переносов
Базовое структурирование достигается за счет систематического внедрения символов переноса строки и пробельных символов. Переносы строк добавляются после каждого закрывающего тега, самозакрывающегося элемента, а также после открытия родительского узла, если он содержит дочерние элементы. Это обеспечивает строгое вертикальное разделение блоков данных.
Горизонтальное позиционирование формируется через механизм Indentation. Логика применения отступов привязана к уровню вложенности элемента в DOM:
- Элементы нулевого уровня располагаются без смещения, вплотную к левому краю.
- При прохождении открывающего тега счетчик глубины иерархии увеличивается на единицу.
- Каждый последующий дочерний элемент получает отступ, равный текущему значению счетчика глубины, умноженному на выбранный шаг форматирования.
- При достижении закрывающего тега счетчик глубины уменьшается, возвращая последующий код на предыдущий визуальный уровень.
Параметры структурирования уровней
Для визуального обозначения шага вложенности (Indent levels) применяются различные символы форматирования. Алгоритм опирается на два основных метода пространственного разделения, выбор которых зависит от технических требований к конечному файлу:
- Пробелы (Spaces). Создают жестко фиксированное визуальное отображение иерархии, которое выглядит идентично в любых системах просмотра. Стандартный шаг форматирования обычно составляет два или четыре пробела на один уровень глубины.
- Табуляция (Tabs). Использует один служебный символ для каждого уровня вложенности. Этот метод позволяет настраивать визуальную ширину отступа в конкретной среде разработки при просмотре, при этом генерируя меньший объем дополнительных байтов в файле по сравнению с множественными пробелами.
Обработка пространств имен и комментариев
Процесс добавления отступов затрагивает исключительно визуальное представление и не нарушает логическую целостность разметки. Пространства имен (xmlns), определяющие принадлежность узлов к конкретным словарям, обрабатываются как неотъемлемая часть тега. Алгоритм сохраняет их внутри скобок узла наряду с обычными атрибутами, не допуская произвольных переносов строк между именем элемента и декларацией xmlns.
Служебные комментарии также требуют точного позиционирования. Поскольку они могут располагаться на любом уровне документа, парсер вычисляет их фактическое положение в дереве относительно родительских и соседних узлов. Если комментарий находится внутри элемента второго уровня глубины, алгоритм применяет к нему соответствующий отступ второго уровня. Это математическое правило гарантирует, что текстовое примечание визуально выравнивается по той же вертикальной оси, что и описываемый им фрагмент данных, сохраняя свою корректную позицию при изменении формата документа.
Интерпретация результатов: визуальный анализ структуры
Преобразование исходного кода формирует Tree View, меняя подход к чтению документа. Сплошной массив символов трансформируется в набор логических блоков, где структурные связи между элементами определяются их позицией на экране. Основной принцип визуального анализа строится на отслеживании вертикальных осей.
Каждый дочерний элемент смещается вправо относительно родительского узла на заданный шаг отступа. Образуется каскадная структура, в которой глубина вложенности читается слева направо. Элементы, расположенные на одной вертикальной линии с одинаковым отступом, являются соседними узлами и принадлежат одному уровню иерархии. Визуальное разделение позволяет глазу мгновенно определять границы начала и конца крупных блоков данных без необходимости построчно вчитываться в названия тегов.
Контроль состояния well-formedness
Структурированный вид выполняет функцию визуального аудита корректности разметки. Оценка состояния well-formedness опирается на следующие маркеры:
- Симметрия элементов. Открывающий и закрывающий теги одного узла всегда находятся на одной вертикальной оси.
- Индикация незакрытых тегов. Отсутствие закрывающего тега заставляет алгоритм форматирования воспринимать все последующие элементы как дочерние, что образует непрерывное смещение текста вправо до конца документа.
- Проверка порядка вложенности. Ошибки перекрестного закрытия тегов визуально разрушают строгий порядок отступов.
Изоляция атрибутов и текстовых узлов
Распределение элементов по отдельным строкам упрощает анализ метаданных. Атрибуты остаются внутри угловых скобок открывающего тега, но благодаря переносам строк они визуально отделяются от значений дочерних нод и соседних элементов. Это ускоряет проверку пар ключ-значение на уровне всего документа.
Строгое форматирование выявляет текстовые узлы и экранированные символы. Изоляция текста между тегами позволяет четко отделить фактические данные от служебной разметки. Наличие HTML entities внутри текстового узла становится контрастным на фоне выровненного кода. Читатель отличает зарезервированные символы разметки от зашифрованных сущностей, исключая путаницу при анализе содержимого.
Практические сценарии использования структурированного XML
В промышленных ИТ-системах данные часто передаются и хранятся в сжатом виде. Удаление пробелов, табуляций и переносов строк сокращает размер файлов, снижает нагрузку на сеть и экономит пространство в базах данных. Однако такой сплошной текст невозможно анализировать вручную. Преобразование сырого кода в структурированный читаемый вид требуется техническим специалистам для решения прикладных задач, связанных с проверкой, отладкой и эксплуатацией систем.
Анализ и отладка ответов API
Взаимодействие между серверами и корпоративными приложениями часто происходит посредством SOAP или REST архитектур, где XML выступает форматом обмена сообщениями. При возникновении проблем с интеграцией инженеру необходимо визуально проанализировать отправленные запросы или полученные ответы. Применение форматирования решает несколько задач отладки:
- Инспекция полезной нагрузки. Структурирование позволяет быстро найти нужный узел с фактическими данными клиента, заказа или транзакции среди десятков служебных обёрточных тегов.
- Анализ ошибок выполнения. В читаемом виде блоки Fault в SOAP-ответах визуально изолируются от остального тела сообщения, ускоряя локализацию причин сбоя.
- Сверка с XSD схемами. Древовидная форма помогает визуально подтвердить наличие обязательных элементов строго на заданных уровнях вложенности.
Аудит конфигурационных файлов
Серверное программное обеспечение, среды исполнения и различные фреймворки используют XML для хранения системных настроек. Конфигурационные файлы могут содержать тысячи строк кода с глубокой вложенностью параметров. Применение отступов критически важно для безопасного ручного аудита таких документов.
Выстроенная визуальная иерархия позволяет системному администратору точно определить, к какому конкретному модулю, сервису или виртуальному хосту относится проверяемый параметр. Сплошной текст резко повышает риск человеческой ошибки, когда значение атрибута при беглом просмотре ошибочно ассоциируется с соседним или родительским тегом. Четкое форматирование исключает визуальное слияние блоков настроек безопасности, маршрутизации и доступа.
Обработка данных из системных логов и баз данных
Системы мониторинга и логирования записывают события в виде непрерывных строк. При расследовании инцидентов, анализе аномалий или проверке целостности транзакций аналитик извлекает фрагменты сырого XML из текстовых лог-файлов или ячеек реляционных баз данных.
Мгновенное приведение такого фрагмента к читаемому виду является обязательным этапом ручной проверки структуры данных. Без структурирования инженер не может оценить объем и взаимосвязи извлеченной информации. Специалист копирует сплошной блок текста из консоли или лог-анализатора, применяет алгоритм форматирования и получает возможность построчно исследовать состояние системы на момент фиксации события.
Подготовка фрагментов для технической документации
При написании спецификаций API, инструкций по интеграции или внутренних руководств для команды разработки необходимо демонстрировать примеры передаваемых данных. Фрагменты кода в технической документации должны представлять собой эталон читаемости.
Публикация сплошного текста недопустима, поскольку скрывает логическую структуру модели данных от читателя. Предварительное структурирование фрагментов обеспечивает строгий и стандартизированный вид примеров. Сторонние разработчики, использующие документацию, могут быстро скопировать корректно выровненный блок кода для вставки в свои тестовые среды, сохраняя правильную визуальную иерархию элементов.