Онлайн-инструмент позволяет сформировать несколько аудиофрагментов из одной записи путем разделения исходного файла по заданным параметрам. В качестве входных данных используется единая звуковая дорожка, которую необходимо разбить на самостоятельные части. Пользователь задает условия разделения, после чего система обрабатывает аудиопоток и формирует серию отдельных файлов. Каждый полученный отрезок сохраняется как независимая аудиозапись, полностью готовая к воспроизведению или дальнейшей обработке.
Такую операцию сегментации важно отличать от обычной обрезки краев. При базовом тримминге из трека выделяется только один целевой участок, а начальная и конечная части попросту удаляются без сохранения.
При разделении аудио на сегменты исходный материал не отбрасывается. Длинная запись последовательно делится в указанных точках на серию отдельных звуковых фрагментов. Этот подход избавляет от необходимости многократно загружать один и тот же объемный файл и вручную вырезать каждый нужный интервал по очереди. В результате одной операции пользователь сразу получает упорядоченный набор аудиофайлов, разделенных строго по выбранным границам на шкале времени.
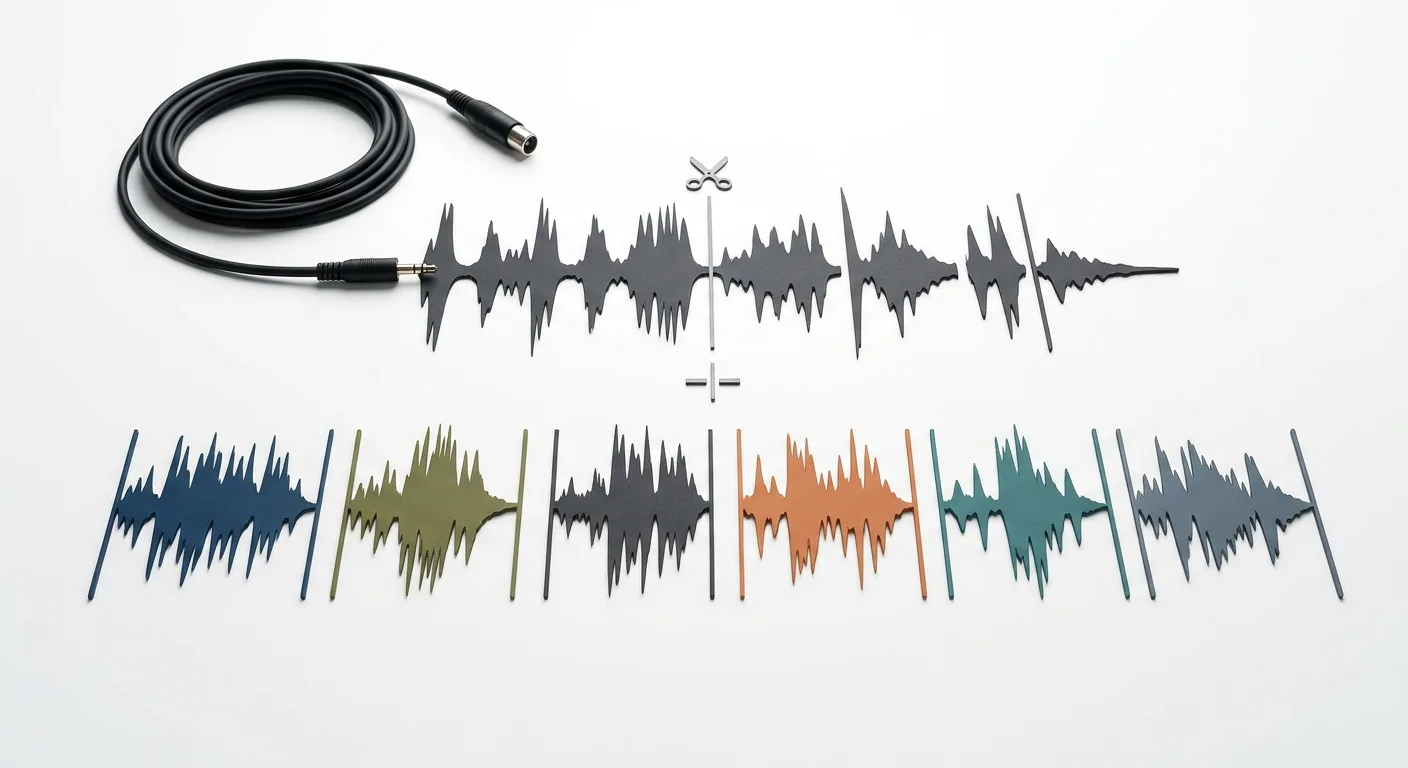
Параметры и логика разбиения звуковой дорожки на сегменты
Для формирования набора отдельных файлов из цельной записи необходимо математически или логически определить координаты точек разреза. В цифровой обработке звука задача сегментации опирается на временную шкалу и амплитудные характеристики сигнала. В зависимости от структуры исходного материала и требований к итоговым файлам применяются три базовых подхода к параметризации границ: указание точных временных координат, задание фиксированного шага длительности и анализ акустических пауз.
Разделение по временным меткам и маркерам диапазона
При таком подходе границы будущих фрагментов задаются явно через конкретные точки на шкале времени. Каждая метка представляет собой временной код в формате часов, минут, секунд и долей секунды, указывающий точное место разделения звукового потока.
На практике этот способ реализуется в двух вариантах задания координат:
- Одиночные точки разреза - задается последовательность конкретных моментов времени, например 00:02:15 и 00:05:40. В этом случае конец предыдущего сегмента автоматически становится началом следующего, а запись делится на сквозные части без пропусков материала.
- Маркеры диапазона - для каждого фрагмента отдельно указывается пара значений: время старта и время окончания. Это позволяет извлечь из дорожки несколько несмежных участков, пропуская ненужные интервалы между ними.
Точная координатная разметка применяется, когда структура записи заранее известна или составлена тайм-код опись. Так как положение границ определяется вручную и не зависит от характера звучания в конкретной точке, полученные отрезки имеют разную продолжительность, строго соответствующую смысловым блокам внутри исходной дорожки.
Нарезка на равные фиксированные интервалы
Логика равномерного разбиения строится на одном базовом параметре - заданной длительности одного сегмента. Вместо перечисления отдельных координат устанавливается постоянный временной шаг, например 30 секунд, 5 минут или 1 час. Отсчет начинается с нулевой отметки файла, и каждая следующая граница формируется путем последовательного прибавления выбранного интервала к предыдущей точке разреза.
Количество получаемых файлов напрямую зависит от общей продолжительности исходной записи и величины заданного шага. Если общая длина аудиодорожки не кратна выбранному интервалу, образуется остаточный финальный сегмент. Например, при разделении записи длительностью 14 минут по 4 минуты формируются три полных участка по 4 минуты и четвертый замыкающий отрезок продолжительностью 2 минуты.
Этот метод не учитывает содержание аудиопотока: линия разреза может пройти прямо посередине произносимого слова или музыкальной фразы. Поэтому фиксированный шаг целесообразен при технической подготовке однородных массивов данных, соблюдении жестких хронометражных ограничений при загрузке файлов на внешние платформы или равномерной разбивке многочасовых фоновых записей.
Сегментация по акустическим паузам
Динамический способ определения границ опирается не на жесткую сетку времени, а на изменение уровня громкости внутри самой записи. Задача сводится к поиску участков условной тишины между звучащими фразами и размещению точек разреза внутри этих пауз. Поскольку в реальной записи вместо абсолютного нуля часто присутствует фоновый шум помещения или микрофона, для корректного обнаружения пауз задаются два связанных параметра:
- Порог громкости - максимальный уровень звукового сигнала в dB, ниже которого звук считается тишиной. Например, при установке значения на отметке -40 dB все тихие фоновые призвуки ниже этого предела воспринимаются как пауза, а более громкая речь или музыка - как полезный сигнал.
- Минимальная продолжительность тишины - время в секундах или миллисекундах, в течение которого уровень сигнала должен непрерывно оставаться ниже установленного порога громкости, чтобы участок был засчитан как точка разделения.
Сочетание этих двух условий предотвращает ошибочное дробление записи. Если задать слишком короткую минимальную длительность паузы, например 0.1 секунды, разрез будет происходить на каждой микропаузе между словами или даже внутри отдельных глухих согласных. Увеличение этого параметра до 1-2 секунд позволяет пропускать естественные речевые заминки и делить дорожку только на границах завершенных смысловых блоков или отдельных композиций. Кроме того, при такой параметризации часто учитывается отступ по краям паузы - сохранение небольшой доли секунды тишины в начале и конце каждого выделенного сегмента, чтобы звук не обрывался слишком резко.
Сравнение методов параметризации разбиения
Выбор подходящей логики определения границ зависит от исходных данных о записи и требований к точности получаемых аудиофрагментов:
| Способ определения границ | Основные входные параметры | Характер длительности сегментов | Типичное условие применения |
|---|---|---|---|
| По временным меткам | Точки времени или пары значений начала и конца | Произвольная, определяется пользователем | Разделение по готовому тайм-коду или выборочное извлечение конкретных сцен |
| По фиксированным интервалам | Длительность одного шага в секундах или минутах | Одинаковая для всех частей, кроме возможного остатка в конце | Равномерная нарезка длинных файлов под лимиты длительности или объема |
| По акустическим паузам | Порог тишины в dB и минимальное время затишья | Переменная, зависит от расположения пауз в записи | Разбивка дикторской речи, списков слов или слитых альбомов с паузами между треками |
Технические аспекты обработки аудиоданных и точность границ разреза
Точность разделения звукового потока на физическом уровне определяется тем, как аудиоданные упакованы внутри файла. В отличие от аналоговой ленты, цифровой звук дискретен - он состоит из последовательности отдельных численных значений или сгруппированных блоков информации. Точка разреза не может находиться в произвольном месте между этими базовыми единицами, поэтому фактическая граница сегмента всегда привязывается к ближайшей структурной единице потока данных.
Параметры цифрового потока при расчете точек сегментации
При переводе временных координат в конкретные позиции внутри файла учитываются базовые характеристики оцифрованного сигнала:
- Частота дискретизации (sample rate) показывает, сколько раз в секунду фиксируется амплитуда звуковой волны. При стандартном значении 44 100 Гц одна секунда записи содержит ровно 44 100 отдельных отсчетов (сэмплов) для каждого канала. Чтобы отделить фрагмент ровно на отметке 10,5 секунды, разрез выполняется после 463 050-го сэмпла.
- Битовая глубина определяет точность представления каждого сэмпла и количество бит, выделяемых на одно измерение амплитуды (например, 16 бит или 24 бита). При сегментации этот параметр задает кратность смещения в байтах: разрез должен проходить строго между полными сэмплами всех активных каналов, иначе структура данных нарушится и вместо звука возникнет цифровой шум.
- Битрейт отражает объем данных, обрабатываемых за одну секунду времени, и измеряется в килобитах в секунду - например, 64 kbps, 192 kbps или 320 kbps. В потоках с постоянным битрейтом позиция разреза в байтах напрямую пропорциональна времени, тогда как при переменном битрейте плотность данных меняется от секунды к секунде, что требует предварительного чтения структуры потока для точного нахождения нужного момента.
Различие между поcэмпловым и фреймовым разделением
Механика формирования отдельных частей напрямую зависит от способа хранения звука. Несжатые форматы, такие как WAV и AIFF, хранят прямую последовательность сэмплов. В них граница разреза (sample boundary) может проходить после любого отсчета. При частоте 48 000 Гц шаг между соседними сэмплами составляет около 0,02 миллисекунды, что дает практически абсолютную точность позиционирования.
Форматам со сжатием, среди которых MP3, AAC и OGG, свойственна блочная структура. Данные в них объединены в неделимые пакеты - фреймы. Каждый фрейм содержит заголовок со служебной информацией и сжатый блок аудиоданных фиксированной продолжительности (например, в MP3 один фрейм обычно включает 1152 сэмпла, что при частоте 44 100 Гц соответствует примерно 26 миллисекундам звучания).
Разделить сжатый поток прямо посередине фрейма без перекодирования невозможно, так как декодер не сможет прочитать неполный блок. При прямом копировании потоковых данных точка разреза смещается к границе ближайшего целого фрейма. Если требуется точность до миллисекунды или конкретного сэмпла внутри сжатого файла, участок записи сначала декодируется в несжатый вид, разрезается по границе сэмпла, а затем снова сжимается.
| Характеристика обработки | Разделение по границам сэмплов (WAV, AIFF) | Прямое разделение по фреймам (MP3, AAC, OGG) |
|---|---|---|
| Минимальный шаг разреза | Один сэмпл (доли миллисекунды) | Один фрейм данных (десятки миллисекунд) |
| Точность соблюдения тайминга | Точное совпадение с заданной меткой | Округление до ближайшей границы фрейма |
| Риск появления микропауз на стыках | Отсутствует при корректной сборке | Возможны зазоры (half-frame gaps) из-за округления |
Природа акустических артефактов и методы сглаживания краев
Даже при идеальном соблюдении границ сэмплов или фреймов на краях полученных аудиофрагментов могут возникать посторонние призвуки - резкие щелчки (clicks и pops). Их причина кроется в физике звуковой волны. Звук представляет собой непрерывное колебание с положительной и отрицательной фазами относительно нулевой оси амплитуды.
Если линия разреза попадает на момент, когда звуковая волна находится на пике или любом ненулевом значении амплитуды, динамик воспроизводящего устройства в конце первого фрагмента мгновенно сбрасывается из отклоненного положения в ноль, а в начале второго фрагмента совершает мгновенный скачок из нуля к высокому значению. Такой вертикальный перепад уровня сигнала воспринимается человеческим ухом как сухой акустический щелчок. Кроме того, при грубом делении фреймовых структур на стыках могут образовываться микроскопические разрывы потока (half-frame gaps), вызывающие кратковременное прерывание звука.
Для предотвращения подобных дефектов в цифровой обработке сигналов применяются два технических приема:
- Поиск пересечения нуля (zero-crossing) - смещение точки разреза на несколько сэмплов вперед или назад до ближайшего места, где график звуковой волны пересекает центральную ось с нулевой амплитудой. Разрез в точке с нулевой энергией исключает резкий скачок мембраны динамика.
- Микро-огибающие громкости (fade-in и fade-out) - применение плавного нарастания звука на первых миллисекундах нового сегмента и плавного затухания на последних миллисекундах предыдущего. Даже сверхкороткое затухание длительностью 5-15 миллисекунд мягко уводит амплитуду волны в ноль на границе разреза, полностью устраняя щелчки на участках с плотным звучанием, где трудно найти чистое пересечение нуля одновременно для левого и правого стереоканалов.
Характеристики выходных аудиофрагментов и используемые форматы
После определения границ нарезки и обработки стыков исходный звуковой поток преобразуется в набор полностью автономных файлов. Простого механического разделения массива байтов недостаточно для корректного воспроизведения полученных отрезков в медиаплеерах. Каждый сформированный аудио-сегмент должен обладать полноценной файловой структурой, которая позволяет операционной системе и программам чтения распознать его как независимую запись.
Формирование заголовков и обработка метаданных
При сохранении каждого отдельного куска записи формируется собственный служебный заголовок файла. В начале контейнера прописываются параметры декодирования, актуальные именно для данного отрезка: его точная расчетная продолжительность, размер блока аудиоданных в байтах, таблица смещений для быстрой перемотки, а также унаследованные от оригинала характеристики потока и конфигурация каналов (mono или stereo). Без индивидуального заголовка плеер не сможет определить длительность фрагмента или вообще откажется его открывать, посчитав файл поврежденным.
Наряду с техническими параметрами потока при генерации выходных файлов решается задача переноса или обновления контейнеров метаданных (например, тегов ID3 для MP3 или комментариев Vorbis для FLAC и OGG). В зависимости от логики формирования выходного набора возможны следующие сценарии работы со встроенной информацией:
- Наследование базовых атрибутов, при котором исполнитель, название альбома, год выпуска и прикрепленная обложка копируются из исходного файла в каждый дочерний сегмент.
- Индивидуальная индексация, предполагающая изменение поля с номером трека и добавление порядкового суффикса к названию каждого фрагмента для сохранения хронологической последовательности при сортировке в папках и плейлистах.
- Очистка служебных блоков, если требуется минимизировать вес коротких звуковых отрезков за счет удаления тяжелых графических обложек и текстовых комментариев, дублирование которых в десятках мелких файлов нерационально.
Конфигурация пространственного звучания в получаемых частях обычно соответствует исходнику. Если оригинальная запись содержала один центральный канал (mono), выходные сегменты сохраняют одноканальную структуру. При разделении двухканальной записи (stereo) синхронно разрезаются оба канала - левый и правый, что исключает фазовый рассинхрон на границах новых треков.
Особенности аудиоформатов и кодеков при сохранении сегментов
Выбор формата для выходных фрагментов напрямую влияет на итоговый размер файлов, совместимость с оборудованием и сохранность исходного качества звучания. В цифровой среде аудиоданные делятся на три основные категории: несжатые форматы, форматы со сжатием без потерь (lossless) и форматы со сжатием с потерями (lossy).
При сегментации записей в форматах без потерь (WAV, FLAC) звуковая волна в каждом новом фрагменте остается математически идентичной оригиналу. В случае с форматами, использующими психоакустическое сжатие с потерями (MP3, AAC, OGG, Opus), способ формирования выходных файлов зависит от того, требуется ли перекодирование потока. Прямое копирование блоков данных в аналогичный контейнер сохраняет исходное качество без деградации, тогда как декодирование с последующим повторным сжатием в lossy-кодек приводит к повторному пересчету спектра и небольшому снижению детализации звука.
В таблице ниже приведены характеристики распространенных в цифровой среде аудиоконтейнеров и кодеков с точки зрения хранения разделенных фрагментов:
| Формат или кодек | Тип хранения данных | Поведение при сохранении сегментов | Типичное назначение выходных файлов |
|---|---|---|---|
| WAV | Несжатый поток | Обеспечивает стопроцентное сохранение исходного качества звука и максимальную точность границ, но создает файлы большого объема. | Дальнейший профессиональный монтаж, сведение в студийных редакторах, хранение мастер-копий и звуковых сэмплов. |
| FLAC | Сжатие без потерь (lossless) | Сохраняет полную побитовую точность оригинала при уменьшении размера файла почти вдвое за счет алгоритмической упаковки. | Архивное хранение музыкальных коллекций, разделение концертных записей и релизов высокого разрешения. |
| MP3 | Сжатие с потерями (lossy) | Обладает максимальной аппаратной и программной совместимостью; при прямом делении без перекодирования не ухудшает исходное звучание. | Повседневное прослушивание на любых плеерах, публикация в интернете, загрузка в автомобильные аудиосистемы. |
| M4A и AAC | Сжатие с потерями (lossy) | Обеспечивает более высокую детализацию звука по сравнению с MP3 при аналогичном размере файла; контейнер M4A удобно хранит разметку и обложки. | Использование в мобильных экосистемах, распространение голосового и музыкального контента на стриминговых площадках. |
| OGG | Контейнер для сжатия с потерями (lossy) | Открытый формат, эффективно работающий со средними и низкими плотностями потока без выраженных металлических призвуков на высоких частотах. | Интеграция звуковых реплик и фоновых дорожек в игровые движки, веб-приложения и мультимедийные каталоги. |
| Opus | Сжатие с потерями (lossy) | Современный кодек с высокой степенью сжатия, адаптирующийся как под узкополосную речь, так и под широкополосную музыку с минимальными задержками. | Хранение длинных речевых архивов, голосовых сообщений, трансляций и потокового аудио при ограниченном месте на диске. |
При выборе целевого формата для нарезанных частей важно учитывать природу самого исходника. Конвертация фрагментов из изначально сжатого формата (например, MP3 или OGG) в несжатый WAV или архивный FLAC не восстановит утраченные ранее частоты, а лишь неоправданно увеличит вес каждого полученного сегмента. Переход в несжатый контейнер оправдан только в тех случаях, когда нарезанные куски планируется загружать в специализированное монтажное программное обеспечение, которое не работает со сжатыми потоками напрямую.
Практические сценарии сегментации длинных аудиозаписей
Выбор подходящего формата напрямую зависит от того, для какой прикладной задачи формируются выходные сегменты. В работе с речевым и музыкальным контентом разделение одного длинного файла на независимые части решает проблемы навигации по записи, упрощает дистрибуцию материала и подготавливает данные к дальнейшей обработке.
Формирование глав из цельной записи аудиокниги
Запись дикторской начитки или оцифровка физических носителей часто сохраняется в виде единого многочасового аудиопотока. Прослушивание такого файла на бытовых плеерах, в автомобильных мультимедийных системах или смартфонах сопряжено с риском потери текущей позиции при случайном сбросе воспроизведения, а перемотка на нужный абзац внутри многочасовой шкалы оказывается слишком грубой.
Такая операция применяется для разделения монолитной аудиокниги на отдельные файлы глав (audiobook chapters). Поскольку дикторы обычно выдерживают выраженную паузу перед объявлением новой главы, границы сегментов определяются либо по этим акустическим затишьям, либо по заранее составленному списку таймкодов оглавления. В результате каждый раздел произведения становится самостоятельным треком, что упрощает переключение между частями книги и освобождает оперативную память воспроизводящего устройства от необходимости буферизовать гигантский файл целиком.
Нарезка подкастов, интервью и вебинаров на тематические блоки
Разговорные шоу, записи онлайн-конференций и экспертные интервью редко бывают однородными по содержанию: за час эфира спикеры успевают обсудить несколько независимых тем, ответить на вопросы слушателей и зачитать партнерские интеграции. Разбиение исходного выпуска подкаста (podcast episodes) или записи вебинара по хронологическим меткам позволяет структурировать этот массив информации под разные каналы распространения.
На практике полученные в результате сегментации аудиофрагменты используются в нескольких направлениях:
- формирование коротких самодостаточных клипов для публикации в социальных сетях и мессенджерах (social clips), содержащих самый яркий тезис, спорный момент или краткую выжимку ответа гостя;
- выделение самостоятельных тематических рубрик из длинного эфира для их отдельной загрузки в специализированные плейлисты или тематические каталоги;
- отделение вступительной части, музыкальных перебивок и блоков с ответами на вопросы в независимые файлы для последующего переиспользования в архивных подборках или дайджестах.
Разделение диктофонных записей для расшифровки и архивации
Полевые исследования, журналистские репортажи, университетские лекции и многочасовые рабочие совещания обычно фиксируются на портативные рекордеры или диктофоны одной непрерывной сессией. Работа с такой цельной записью неудобна при подготовке текстовой документации (транскрибации) и систематизации архива.
Если длинная голосовая заметка разбивается на части равной фиксированной длительности (например, на отрезки по 10 или 15 минут), полученный набор файлов можно распределить между несколькими стенографистами или редакторами для параллельной расшифровки. Когда же нарезка выполняется по смысловым границам - от одного докладчика к другому или от одного вопроса повестки к следующему - каждый отдельный аудиосегмент можно снабдить точным названием и сохранить в профильную папку проекта, не заставляя коллег прослушивать часовую запись ради двухминутного комментария.
Выделение музыкальных отрезков и создание звуковых сигналов
В работе с музыкальными записями, концертными бутлегами или студийными репетициями разделение аудиодорожки помогает извлечь конкретные композиционные элементы из общего потока. На живых выступлениях треки часто идут без остановки записи (нон-стоп сетом), и сегментация по таймкодам позволяет разбить полуторачасовой концерт на отдельные песни для создания полноценного трек-листа альбома.
При работе с отдельной студийной композицией точное разделение по границам вступления, куплета, припева или инструментального проигрыша используется для получения коротких функциональных отрезков. Полученный результат можно использовать для установки в качестве телефонного рингтона, сигнала будильника или системного уведомления, а также для сохранения удачных гитарных риффов, сэмплов ударных партий или вокальных фраз в рабочую библиотеку музыканта.
Соотношение прикладных задач, исходного материала и подходящей логики разбиения представлено в сводной таблице:
| Прикладная задача | Характер исходной записи | Способ определения границ разреза | Практическое назначение выходных сегментов |
|---|---|---|---|
| Формирование глав аудиокниги (audiobook chapters) | Многочасовая дикторская начитка художественной или учебной литературы | По длительным паузам между главами или по таймкодам оглавления | Удобная постраничная и поглавная навигация в аудиоплеерах |
| Экспорт фрагментов подкастов (podcast episodes) и вебинаров | Длинная диалоговая запись, интервью, дискуссионный эфир | По точным временным меткам смены тем или ярких цитат спикеров | Публикация коротких анонсов (social clips), выпуск тематических нарезок |
| Обработка диктофонных голосовых заметок | Непрерывная запись лекции, совещания, судебного заседания или брифинга | На равные временные интервалы либо по смысловым блокам доклада | Параллельная текстовая расшифровка силами нескольких человек, предметная архивация |
| Выделение музыкальных отрезков и рингтонов | Концертная запись без остановок или отдельная музыкальная композиция | По таймкодам начала песен, припевов или инструментальных соло | Использование в качестве мелодии вызова, разделение концертного сета на треки |
Отличие хронологического разделения от смежных задач аудиомонтажа
В работе со звуком понятие «разделение» часто применяется к совершенно разным по своей технической природе процессам. Хронологическое разбиение аудиофайла на части (Audio Splitting) работает исключительно с временной осью записи, не изменяя внутренний частотный баланс или состав звучащих источников внутри отдельного момента времени. Чтобы правильно выбрать подход к обработке исходного материала, необходимо строго разграничивать пакетную временную сегментацию и другие операции аудиомонтажа.
Разница между пакетным разделением и обрезкой краев
Операции разбиения (Audio Splitting) и тримминга (Audio Trimming или Cutting) опираются на схожую механику чтения потока данных по таймкодам, но решают противоположные задачи с точки зрения структуры выходных файлов.
При тримминге задается один целевой диапазон с точками начала и конца, который необходимо извлечь. Все данные до начального маркера и после конечного маркера отбрасываются как ненужные (например, затянутое вступление, фоновый шум перед началом речи или аплодисменты в конце записи). На выходе всегда формируется ровно один укороченный аудиофайл. При удалении фрагмента из середины записи (вырезании оговорки или рекламной вставки) оставшиеся левая и правая части склеиваются обратно в единую дорожку.
Хронологическое разделение, напротив, направлено на сохранение всех или нескольких частей исходного материала в виде самостоятельных единиц. Один входной файл порождает массив независимых выходных файлов (1 → N). Даже если из часовой записи требуется получить только три конкретных пятиминутных блока из разных мест, именно логика разделения формирует из них три отдельных трека за один цикл, тогда как при классической обрезке пришлось бы повторять процедуру выделения и сохранения трижды.
Соотношение с операцией слияния аудиодорожек
Слияние или склейка треков (Audio Joining или Merging) представляет собой прямую математическую и структурную противоположность процессу разделения. Если при сегментации единый поток аудиоданных распадается на серию файлов, то при слиянии несколько разрозненных файлов последовательно выстраиваются вдоль общей временной шкалы и объединяются в один непрерывный контейнер (N → 1).
С технической точки зрения эти две операции предъявляют разные требования к исходным данным. Для разделения достаточно одного корректного файла - все получаемые сегменты естественным образом унаследуют его частоту дискретизации, количество каналов и битовую глубину. Для слияния нескольких разных записей требуется предварительное приведение всех входных файлов к единым параметрам звука, иначе прямое объединение потоков данных приведет к искажению скорости воспроизведения или ошибкам декодирования на стыках.
Хронологическая нарезка против спектрального демиксинга и диаризации
Наиболее частая путаница в терминологии возникает между разделением записи во времени и разделением звука по источникам. Когда пользователь формулирует задачу как «разделить песню на минус и голос» или «разделить диалог на отдельных дикторов», речь идет о совершенно ином классе вычислительных задач.
Хронологическая сегментация делает вертикальные разрезы поперек временной шкалы. Если в конкретную секунду записи одновременно звучат вокал, гитара и ударные либо перебивают друг друга два собеседника, все эти звуки останутся смешанными внутри полученного временного отрезка. Для разделения одновременно звучащих партий применяются другие технологии:
- Спектральный демиксинг (Source Separation или Stem Splitting) - разделение сведенной музыкальной композиции на отдельные инструментальные и вокальные дорожки (стемы). Процесс основан на частотно-временном анализе спектрограммы и работе нейросетевых моделей, которые распознают характерные тембральные маски голоса, баса, ударных и синтезаторов. На выходе получается несколько файлов одинаковой длительности (равной исходному треку), в каждом из которых звучит только выделенная партия.
- Диаризация спикеров (Speaker Diarization) - распознавание и разделение речевой записи по голосам конкретных участников беседы. Эта задача решается с помощью алгоритмов машинного обучения, анализирующих биометрические и акустические характеристики голоса (высоту основного тона, форманты, тембр). Система определяет, кто именно говорит в каждый отрезок времени, и группирует реплики каждого человека в отдельные потоки или размеченные текстовые блоки.
Если участники интервью говорят строго по очереди с заметными паузами, обычная хронологическая нарезка по тишине или таймкодам позволит получить отдельные файлы для каждой реплики. Однако сама по себе временная сегментация не анализирует тембр голоса: она не способна рассортировать полученные файлы по папкам конкретных спикеров или разделить голоса при одновременной речи.
Сравнение смежных операций обработки звука
Для точного выбора типа обработки перед началом монтажа можно ориентироваться на соотношение входных данных, принципа воздействия на звук и структуры получаемого результата, представленное в таблице:
| Операция обработки | Соотношение входа и выхода | Принцип работы с аудиоданными | Длительность выходных файлов | Типичный результат |
|---|---|---|---|---|
| Хронологическое разделение (Audio Splitting) | Один исходный файл → несколько выходных файлов | Поперечный разрез потока данных по временным меткам, интервалам или паузам | Сумма длительностей всех частей равна длительности исходника (или выбранных диапазонов) | Набор последовательных глав, тематических блоков или коротких клипов |
| Обрезка краев (Audio Trimming) | Один исходный файл → один выходной файл | Отсечение начального и конечного участков за пределами выбранного интервала | Меньше длительности исходного файла | Очищенная от лишних краев запись или один извлеченный фрагмент |
| Слияние дорожек (Audio Joining) | Несколько исходных файлов → один выходной файл | Последовательное соединение нескольких аудиопотоков на одной временной оси | Равна сумме длительностей всех объединяемых файлов | Единый склеенный микс, компиляция или цельный выпуск из отдельных рубрик |
| Спектральный демиксинг (Stem Separation) | Один исходный файл → несколько выходных файлов | Частотный анализ и нейросетевая фильтрация одновременно звучащих слоев | Длительность каждого выходного файла равна длительности исходного трека | Изолированная дорожка вокала, отдельная инструментальная минусовка, партии ударных и баса |
| Диаризация речи (Speaker Diarization) | Один исходный файл → размеченные потоки по числу спикеров | Акустическая идентификация тембра голоса и кластеризация речевых отрезков | Зависит от суммарного времени речи каждого конкретного участника | Разделенные дорожки реплик разных дикторов или хронометраж смены говорящих |